Parcourir les catégories
Explorer
Fiverr Pro
Français
$
USD
Expert en automatisation de workflow, LLMs, bots, OCR
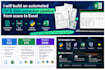
Arrêtez de payer à l’heure pour la saisie manuelle. Je crée des pipelines automatisés qui extraient des données structurées directement à partir de documents scannés, PDFs et images, sans besoin de ressaisie manuelle.
Ce que je fais :
Pour qui cela est-il destiné :
Technologies que j’utilise : Python, Tesseract OCR, Pandas, OpenPyXL, PostgreSQL, DuckDB
Traduction automatique
Avec quels formats de fichiers pouvez-vous travailler ?
R : PDFs scannés, images JPG/PNG, et fichiers TIFF multi-pages. Envoyez un exemple et je confirmerai la précision avant votre commande.
Que faire si mes documents ont des mises en page désordonnées ou incohérentes ?
R : Je crée un script de parsing personnalisé adapté à votre mise en page spécifique. Envoyez 2 à 3 fichiers d’exemple avec votre commande pour que je puisse l’ajuster correctement.
Pouvez-vous configurer cela pour que mon équipe puisse le faire elle-même plus tard ?
R : Oui — Les packages Standard et Premium incluent le script et des instructions de base pour que vous ne dépendiez pas de moi pour chaque nouveau lot.
Garantissez-vous une précision OCR de 100 % ?
R : La précision OCR dépend de la qualité du scan. J’inclus une étape de validation/nettoyage pour repérer et signaler les erreurs potentielles, mais les scans de très mauvaise qualité peuvent nécessiter une revue manuelle.


