Parcourir les catégories
Explorer
Fiverr Pro
Français
$
USD


Traduction automatique
Votre système RAG récupère-t-il les mauvais documents, hallucine-t-il, produit-il des citations peu fiables ou répond-il trop lentement ?
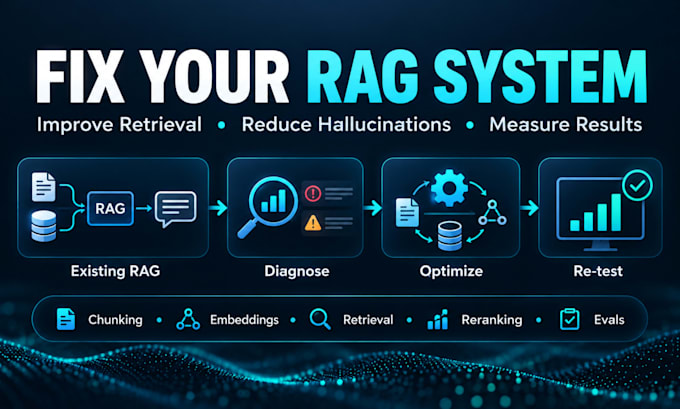
Je vais diagnostiquer et optimiser votre pipeline RAG existant en utilisant des tests mesurables avant/après, pas des changements de prompt aléatoires.
Je peux aider à améliorer :
- La stratégie de découpage
- Les embeddings et la recherche vectorielle
- La précision de la récupération
- Le filtrage par métadonnées
- La recherche hybride
- Le reranking
- La construction de prompts et de contexte
- La réduction des hallucinations et l'ancrage
- La qualité des citations
- La latence et l'utilisation des tokens
- La performance de la base de données vectorielle
- L’évaluation RAG
Ma méthode :
Mesurer -> Diagnostiquer -> Corriger -> Retester -> Comparer
Je travaille avec des systèmes RAG basés sur Python, LangChain, LlamaIndex, FastAPI, OpenAI, Claude, des LLM locaux, Pinecone, Qdrant, Chroma, Weaviate, pgvector et des stacks similaires.
Vous recevrez des preuves claires de :
- La cause du problème
- Ce qui a été modifié
- La performance du système avant et après
- Les limitations restantes
Ce service s'adresse aux systèmes RAG existants. Pour des systèmes de production importants, des intégrations multiples ou des reconstructions d'architecture, veuillez me contacter avant de commander.
AI and Data Science Engineer, RAG, MCP and LLM Automation
Langues
Traduction automatique
Traduction automatique
1. Construisez-vous un nouveau système RAG à partir de zéro ?
Ce service se concentre sur le diagnostic et l’amélioration d’un pipeline RAG existant. Le développement d’un nouveau système doit être traité comme un projet personnalisé.
2. Pouvez-vous réduire les hallucinations ?
Oui. J’étudie si les hallucinations proviennent de la récupération, du découpage, de la construction du contexte, du prompting, des citations ou du comportement du modèle, et je corrige la cause réelle.
3. Pouvez-vous améliorer la précision de la récupération ?
Oui. Je peux revoir le découpage, les embeddings, la recherche vectorielle, les filtres de métadonnées, la recherche hybride, le reranking et les réglages de récupération.
4. Pouvez-vous travailler avec Pinecone, Qdrant, Chroma, Weaviate ou pgvector ?
Oui, en fonction de votre architecture actuelle et de vos besoins spécifiques.
5. Pouvez-vous optimiser la latence et le coût de l’API ?
Oui. La latence, l’utilisation des tokens, la taille du contexte, les appels inutiles au LLM et l’efficacité de la récupération peuvent être examinés et optimisés.
6. Pouvez-vous garantir une amélioration précise de la précision ?
Non. Je mesure d’abord la ligne de base actuelle, puis je rapporte l’amélioration réelle obtenue sur des cas de test représentatifs.
7. De quoi avez-vous besoin de ma part pour commencer ?
Veuillez fournir votre code source ou votre dépôt, l'architecture RAG actuelle, la base de données vectorielle, le modèle d'embedding, des exemples de documents de la base de connaissances, des questions de test représentatives et quelques exemples des échecs que vous souhaitez corriger. Si vous avez des réponses attendues, des journaux ou des résultats d'évaluation, cela peut également aider