Parcourir les catégories
Explorer
Fiverr Pro
Français
$
USD
Ingénieur de données
Vous avez du mal avec des données dispersées, des rapports manuels ou des pipelines lents ? J’aide les entreprises à automatiser et à faire évoluer leur infrastructure de données, du source brut aux données propres et prêtes à l’emploi.
Je suis ingénieur en données cloud spécialisé dans la conception de pipelines de données sécurisés et évolutifs. Que vous ayez besoin d’un simple ETL batch ou d’un streaming en temps réel complexe, je conçois et déploie la solution adaptée à vos besoins.
Compétences et services :
- Pipelines de bout en bout : workflows ETL/ELT avec Python, SQL, Apache Airflow
- Streaming en temps réel : Apache Kafka pour l’IoT et les données d’événements
- Entrepôts cloud : Snowflake et AWS
- Web scraping : Selenium et APIs
- Transformations : modélisation dbt, tableaux de bord Streamlit
- Déploiement : applications Dockerisées sur AWS EC2
Pourquoi travailler avec moi ?
Code propre, bien documenté et prêt pour la production
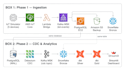
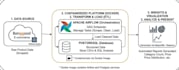
Diagrammes d’architecture inclus
Documentation claire pour des transferts faciles
Communication rapide et réactive
Chaque projet est unique, envoyez-moi vos besoins avant de commander pour que je puisse vous recommander le meilleur package.
Transformons vos données désordonnées en un système qui fonctionne simplement.

Traduction automatique
De quelles informations avez-vous besoin de moi pour commencer ?
Veuillez partager votre source de données (par exemple, API, base de données, fichiers CSV), votre destination (AWS ou Snowflake), ainsi que toute exigence spécifique de transformation. Plus vous fournirez de détails, plus je pourrai livrer rapidement.
Pouvez-vous gérer le streaming de données en temps réel ?
Absolument ! Je suis spécialisé dans la mise en place d’architectures de streaming d’événements en temps réel avec Apache Kafka et AWS, et je peux les intégrer à votre entrepôt de données cible comme Snowflake.
Fournissez-vous une documentation pour les pipelines de données ?
Oui, je fournis une documentation claire et des diagrammes d’architecture professionnels pour chaque projet. Cela vous permet de comprendre le flux de données et de le maintenir facilement à l’avenir.
Fournissez-vous le code source ?
Oui, le code source est inclus dans tous les packages afin que vous en ayez la pleine propriété et que vous puissiez maintenir le pipeline vous-même à l'avenir.
Que faire si mon projet ne correspond pas exactement à un package ?
Pas de problème — envoyez-moi vos besoins avant de commander, et je vous recommanderai le meilleur package ou créerai une offre personnalisée pour vous.
Combien de révisions ai-je ?
Le package de base comprend 2 révisions, le standard en comprend 3, et le premium en comprend 4.


