Parcourir les catégories
Explorer
Fiverr Pro
Français
$
USD


Traduction automatique
Êtes-vous prêt à exploiter la puissance des LLMs et de l'IA personnalisée pour votre entreprise ?
Je suis développeur logiciel spécialisé dans les intégrations d'intelligence artificielle, les architectures RAG (Retrieval-Augmented Generation) et les applications web modernes. Que vous ayez besoin d'une API backend simple ou d'une application de chat complète et sécurisée pour interroger vos propres documents, je peux concevoir une solution robuste adaptée à vos besoins.
Ce que je propose :
Systèmes RAG personnalisés : discuter avec vos PDFs, bases de données ou documents d'entreprise en utilisant des LLM locaux ou cloud.
Backend & API : endpoints rapides, sécurisés et évolutifs, construits avec python et fastapi, entièrement optimisés pour le streaming de tokens.
Solutions full-stack : interfaces frontend réactives et fluides développées avec React et TypeScript.
Déploiement local d'IA : configuration de modèles locaux respectueux de la vie privée avec Ollama et bases de données vectorielles comme Qdrant.
Ma stack technologique :
Python, FastAPI, React, TypeScript, JavaScript, SQL, Ollama, Qdrant, Hugging Face.
Veuillez m'envoyer un message avant de passer commande ! Je souhaite comprendre vos besoins spécifiques pour que nous choisissions la meilleure approche architecturale pour votre projet.
AI Backend Engineer RAG Vector Search
Langues
Traduction automatique
Traduction automatique
Pourquoi devrais-je choisir une architecture IA personnalisée plutôt que des plateformes commerciales génériques ?
Une solution sur mesure vous donne une propriété et un contrôle total. Au lieu d'imposer vos données dans un cadre rigide, nous concevons un pipeline RAG adapté à votre logique métier tout en évitant la dépendance à un fournisseur.
Comment le système lit-il et recherche-t-il dans mes documents d'entreprise spécifiques ?
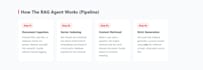
Nous intégrons des bases de données vectorielles modernes, comme Qdrant, pour traiter vos PDFs, bases de données ou textes d'entreprise. Cela permet au système de trouver instantanément le contexte le plus pertinent basé sur la signification sémantique, en fournissant la bonne information à l'IA.
Comment empêchez-vous l'IA d'inventer des faits (hallucinations) ?
L'architecture utilise une approche RAG stricte. Le modèle est limité à répondre uniquement en utilisant le contexte extrait de vos documents vérifiés. Nous séparons la logique stricte de la génération de langage pour garantir que vos données restent 100 % précises.
Cela peut-il gérer des données d'entreprise très sensibles ?
Absolument. Pour une sécurité maximale, je peux mettre en place des déploiements IA locaux respectueux de la vie privée avec Ollama. Cela signifie que les modèles de langage et vos données fonctionnent entièrement sur votre infrastructure, sans jamais être envoyés à des API tierces.
Quelles technologies utilisez-vous pour l'application ?
Le backend est alimenté par python et fastapi, garantissant des endpoints rapides, évolutifs et optimisés pour le streaming de tokens IA. Si vous souhaitez une solution full-stack, le frontend est construit avec React et TypeScript réactifs.
Comment démarrer un nouveau projet ?
Veuillez m'envoyer un message direct avant de passer commande. Nous discuterons de vos besoins spécifiques, des types de données et de l'utilisation pour assurer la meilleure approche architecturale pour votre projet.


