Parcourir les catégories
Explorer
Fiverr Pro
Français
$
USD


Traduction automatique
Souhaitez-vous améliorer votre application avec une recherche sémantique haute performance, des embeddings vectoriels personnalisés et une correspondance rapide des similarités ?
Je me spécialise dans la construction d'architectures de bases de données vectorielles pour la production, de pipelines de recherche sémantique et d'algorithmes de similarité personnalisés en utilisant Python, FastAPI, Qdrant et PostgreSQL (pgvector).
Ce que je propose :
Intégration de bases de données vectorielles : configuration et optimisation de Qdrant, PostgreSQL (pgvector), Chroma ou FAISS.
Pipelines d'embedding : découpage de texte, optimisation des tokens, modèles locaux (SentenceTransformers, E5, BGE) ou cloud (OpenAI).
Algorithmes de similarité personnalisés : calculs de similarité cosinus, distance euclidienne et produit scalaire.
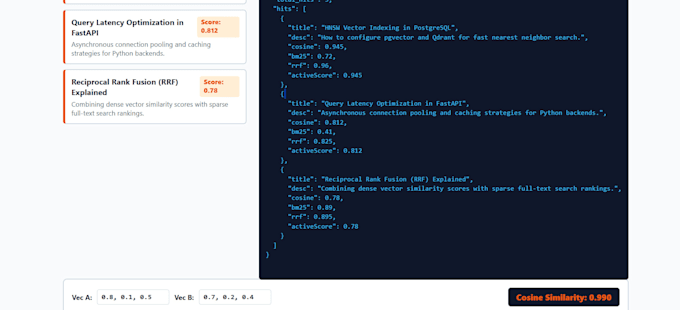
Recherche hybride : fusion de la recherche en texte intégral traditionnelle avec la récupération de vecteurs denses utilisant Reciprocal Rank Fusion (RRF).
APIs de production : endpoints REST asynchrones conçus avec Python, FastAPI et validation Pydantic.
Pile technologique :
Python, FastAPI, Qdrant, PostgreSQL (pgvector), SentenceTransformers, Hugging Face, PyTorch, Docker.
Veuillez m’envoyer un message avant de passer commande pour discuter de votre jeu de données et de vos besoins !
AI Backend Engineer RAG Vector Search
Langues
Traduction automatique
Traduction automatique
Pourquoi utiliser la recherche vectorielle plutôt que la recherche par mots-clés traditionnelle ?
La recherche traditionnelle recherche des correspondances exactes de mots. La recherche vectorielle analyse la signification sémantique, trouvant un contexte pertinent même lorsque les utilisateurs utilisent des synonymes ou des formulations différentes.
Cela peut-il fonctionner 100 % localement pour une confidentialité totale des données ?
Oui. Je peux configurer des modèles d'embedding locaux (comme E5 ou BGE via SentenceTransformers) et des bases vectorielles locales (Qdrant ou pgvector) pour que aucune donnée ne quitte votre serveur.
Qu'est-ce que la recherche hybride et pourquoi est-elle meilleure ?
La recherche hybride combine la recherche en vecteurs denses (signification sémantique) avec la recherche par mots-clés clairsemés (BM25 ou texte intégral PostgreSQL) en utilisant Reciprocal Rank Fusion (RRF) pour une précision maximale.