Parcourir les catégories
Explorer
Fiverr Pro
Français
$
USD


Traduction automatique
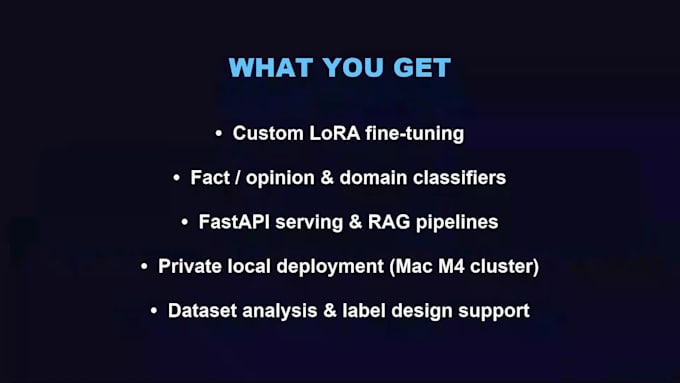
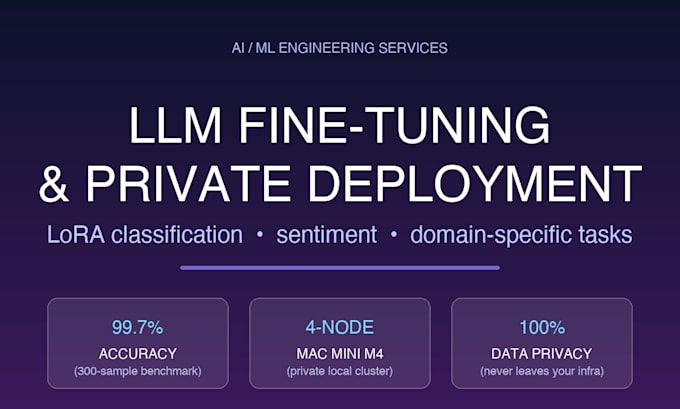
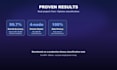
Fine-tuning personnalisé de LLM avec LoRA/QLoRA pour la classification, l’analyse de sentiment, le transfert de style et les tâches spécifiques à un domaine. J’ai créé un classificateur binaire de faits/opinions avec Qwen3-14B-4bit LoRA qui a atteint 99,7 % de précision, et je déploie tout sur mon cluster privé de 4 Mac Mini M4, votre data ne quitte jamais votre environnement.
Ce que je propose :
Pourquoi me choisir :
Avant de commander : envoyez-moi un message avec votre tâche, la taille et le format du dataset, la langue cible et la date limite pour que je puisse confirmer la faisabilité et le délai de livraison.
AI ML Engineer, LLM Fine tuning and Private Deployment Specialist
Langues
Traduction automatique
Traduction automatique
De quelles données avez-vous besoin de moi ?
Échantillons étiquetés ou non étiquetés en CSV/JSON, ou une description de tâche.
Mes données resteront-elles privées ?
Oui, tout le travail s’effectue sur mon cluster privé local, les données ne quittent jamais votre infrastructure.
Que vais-je recevoir après la livraison ?
Poids du modèle ajusté, rapport d’évaluation et guide/API de déploiement si applicable.
Quels modèles affinez-vous ?
Modèles open source populaires tels que Qwen, Llama, Mistral, et plus, utilisant LoRA/QLoRA efficace.
Combien de temps cela prendra-t-il ?
Les tâches typiques de petite à moyenne taille sont livrées en 3 à 7 jours, selon le volume de données et la charge du cluster.
Pouvez-vous traiter des données textuelles non anglaises ?
Oui, je peux ajuster des modèles multilingues comme Qwen, BLOOM ou MiniLM multilingue pour des tâches de classification et NLP non anglophones. Indiquez votre langue et votre domaine, je configurerai le bon modèle pour vous.
Quelles options de déploiement proposez-vous ?
Déploiement privé via FastAPI + Docker (ou MLX/vLLM pour un débit de production) sur vos propres machines — Mac Mini, Linux ou serveurs Windows. J'ai aussi mis en place un point d'API interne pour votre équipe.
À quelle précision puis-je m'attendre ?
Cela dépend de la qualité des données et de la difficulté de la tâche. À titre de référence, mon classificateur de faits/opinions avec Qwen3-14B LoRA a atteint 99,7 % de précision. Vous recevez toujours un rapport d'évaluation complet avec la précision, le F1 et une analyse des erreurs.
Pourquoi utiliser LoRA/QLoRA plutôt que le fine-tuning complet ?
LoRA/QLoRA ne met à jour qu'une petite partie des paramètres, réduisant le coût d'entraînement et la mémoire jusqu'à 90 %, tout en conservant une qualité proche du fine-tuning complet. Cela s'entraîne plus rapidement et génère moins d'artefacts, ce qui rend le déploiement privé sur du matériel modeste pratique.