Parcourir les catégories
Explorer
Fiverr Pro
Français
$
USD
Ingénieur en données IA, pipelines RAG, PDF vers Markdown, LLMs locaux
Protégez vos données d'entreprise propriétaires avec une IA entièrement privée, finetunée localement.
L'envoi de documents sensibles, de matériel pédagogique ou de connaissances internes vers des API cloud publiques représente un risque majeur pour la sécurité et viole souvent les réglementations GDPR.
Je crée des modèles d'IA sécurisés, hors ligne, adaptés à votre secteur spécifique. En utilisant une architecture Apple Silicon haut de gamme (128 Go de mémoire unifiée) et des frameworks avancés comme MLX et Unsloth, vos données ne quittent jamais mon matériel isolé lors de la formation.
Ce que je fournis :
Ma stack technologique & expertise :
N'hésitez pas à me contacter avant de passer commande.


Langage de programmation:
Python
Type de données:
Texte
Moteur d'IA:
Autres
Traduction automatique
Pourquoi devrais-je faire un finetuning local plutôt que d'utiliser OpenAI ou d'autres API cloud ?
Les API cloud présentent un risque majeur pour la sécurité des données propriétaires de l'entreprise et violent souvent les politiques strictes du RGPD. Le finetuning local garantit que vos documents sensibles, données clients et connaissances internes ne quittent jamais un environnement isolé et hors ligne. Vous conservez 100 % de souveraineté sur vos données.
Pouvez-vous faire un finetuning de modèles plus grands sur du matériel local ?
Oui. J'utilise une architecture Apple Silicon haut de gamme avec 128 Go de mémoire unifiée. Associé à des frameworks de quantification avancés comme MLX et Unsloth (QLoRA), cette bande passante mémoire massive me permet de finetuner et d'exécuter efficacement de grands modèles open source (comme Llama, Mistral ou Qwen) entièrement hors ligne.
Dans quel format doivent être mes données d’entraînement ?
Pour le package Standard, vos données doivent être préparées sous forme d'un fichier JSONL propre contenant des paires instruction-réponse structurées. Si vos connaissances sont actuellement enfermées dans des PDFs désordonnés, du texte brut ou des documents internes, mon package Premium inclut un prétraitement Python personnalisé pour extraire, nettoyer et formater
Quels fichiers exacts vais-je recevoir à la livraison ?
Vous recevrez les poids de l'adaptateur LoRA finetuné ainsi qu'un fichier modèle entièrement fusionné et quantifié (format GGUF). Ce fichier GGUF est prêt pour le déploiement et peut être instantanément glissé-déposé dans des moteurs d'inférence locaux comme Ollama, LM Studio ou AnythingLLM sur votre propre matériel d'entreprise.
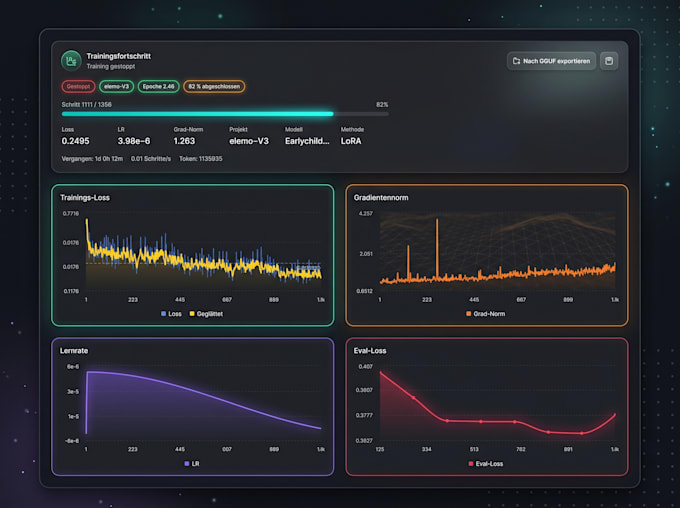
Comment garantissez-vous que le modèle apprend réellement mon domaine et ne se contente pas de surajuster ?
Je surveille rigoureusement les courbes de perte d'entraînement et ajuste les hyperparamètres pour assurer une bonne généralisation du modèle à votre terminologie spécifique.