Parcourir les catégories
Explorer
Fiverr Pro
Français
$
USD
analyste de données
Tarification pour nouveau vendeur : les 5 premières commandes sont à prix réduit pendant que je construis mon historique d'avis.
Un modèle que vous pouvez défendre, pas seulement un score en qui vous devez avoir confiance.
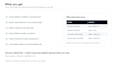
Ce que vous obtenez
- Validation honnête : séparation stratifiée ou basée sur le temps, rapportée telle quelle
- Ingénierie des caractéristiques adaptée à votre activité : RFM, comportemental, transactionnel, basé sur le temps
- Modèles comparés sur la même séparation, pour que le choix soit justifié plutôt qu'hypothétique
- Gestion correcte du déséquilibre de classes : SMOTE, poids de classe ou réglage du seuil
- Importance des caractéristiques classée et traduite en termes commerciaux
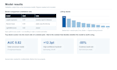
- Un résumé compréhensible par un non-technicien : AUC, lift, précision à K
Outils : Python (Pandas, scikit-learn, NumPy, LightGBM), SQL
Expérience : modèles de churn et de rappel avec AUC 0,80, prédiction de conversion de commande sur 47 caractéristiques avec AUC 0,82, et un modèle de scoring de leads qui a augmenté le taux de transfert à haute confiance de 7,7 % à 20 %.
Ce dont j'ai besoin : une colonne cible, quelques milliers de lignes d'historique, et la décision que le score doit influencer. Si vos données sont encore désordonnées, je peux les nettoyer dans le cadre du niveau Premium, ou vous pouvez d'abord commander mon service de nettoyage de données Gig.
Envoyez-moi le nombre de lignes et la colonne cible, je confirmerai le périmètre avant votre commande.
Langage de programmation:
Python
•
SQL
Frameworks:
Scikit-learn
•
Panda
Outils:
Jupyter Notebook
•
Excel
Traduction automatique
Quel algorithme allez-vous utiliser ?
Selon le problème, pas par habitude : modèles linéaires régularisés comme base, forêts d'arbres (LightGBM, scikit-learn), SVM ou k-NN pour petites données non linéaires, clustering pour segments, ranking pour listes ordonnées. Choisis lors de la validation, jamais par mode - et je vous dis ce que j'ai rejeté.
À quelle précision puis-je m'attendre ?
Je ne promets pas un chiffre avant d'avoir vu les données, et quiconque le fait n'est qu'en train de deviner. Ce à quoi je m'engage, c'est une validation honnête et un rapport clair sur où le modèle échoue. Pour référence, mes propres projets ont atteint une AUC de 0,80 à 0,82 sur des problèmes de churn et de conversion.
Mon jeu de données est petit ou déséquilibré. Pouvez-vous quand même travailler avec ?
Généralement oui. Le déséquilibre est géré avec SMOTE, des poids de classe ou le réglage du seuil plutôt qu'ignoré. Les petites données constituent une limite réelle — s'il y a trop peu de cas positifs, je vous le dirai clairement avant votre commande, plutôt que de livrer un modèle peu fiable.
Vais-je recevoir le code ?
Oui, dans tous les packages. Vous recevez un notebook ou un script que vous pouvez relancer, ainsi que la liste finale des caractéristiques. Le niveau Premium ajoute un script de production, une documentation écrite et un appel de transfert.
Pouvez-vous déployer le modèle en production pour moi ?
Je ne fais pas de déploiement cloud ni d'intégration API, et je préfère le préciser dès le départ plutôt que de prendre la commande et de vous décevoir. Ce que vous obtenez, c'est un modèle et un script prêts à être déployés par votre équipe d'ingénierie.
Mes données sont sensibles. Comment gérez-vous cela ?
Envoyez un extrait masqué ou un petit échantillon si vous préférez. Je demande uniquement les colonnes dont le modèle a réellement besoin, je ne partage pas vos fichiers avec personne, et je supprime la copie de travail une fois la commande terminée.


