Parcourir les catégories
Explorer
Fiverr Pro
Français
$
USD
Vous avez besoin de déplacer, transformer, nettoyer ou synchroniser des données entre des bases de données, des fichiers ou des API ?
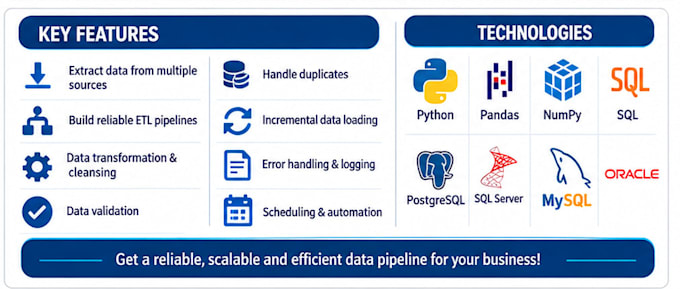
Je vais créer un pipeline ETL/ELT de données fiable utilisant Python et SQL pour transférer des données entre différentes sources et bases cibles.
Je peux concevoir des pipelines simples par lot ainsi que des solutions d’intégration de données plus structurées.
Je peux créer des pipelines pour :
TECHNOLOGIES
Traduction automatique
Q : Pouvez-vous déplacer des données entre PostgreSQL et SQL Server ?
R : Oui. Je peux créer des pipelines par lot entre PostgreSQL et SQL Server.
Q : Pouvez-vous travailler avec des APIs ?
R : Oui. Je peux extraire des données à partir d’API REST et les charger dans des bases de données.
Q : Pouvez-vous gérer de grands ensembles de données ?
R : Oui. Je peux utiliser le traitement par lot, le chargement incrémental et le traitement côté base pour réduire la mémoire et la surcharge de la base de données.
Q : Pouvez-vous nettoyer les données en double ?
R : Oui. Je peux mettre en œuvre des règles de validation et de détection de doublons selon vos besoins métier.
Q : Pouvez-vous planifier le pipeline ?
R : Oui. La planification peut être réalisée avec des outils comme cron ou d’autres plateformes d’orchestration selon votre environnement.