Parcourir les catégories
Explorer
Fiverr Pro
Français
$
USD
IA et ML
Vous avez un problème de classification mais vous ne savez pas quel modèle correspond réellement à vos données ?
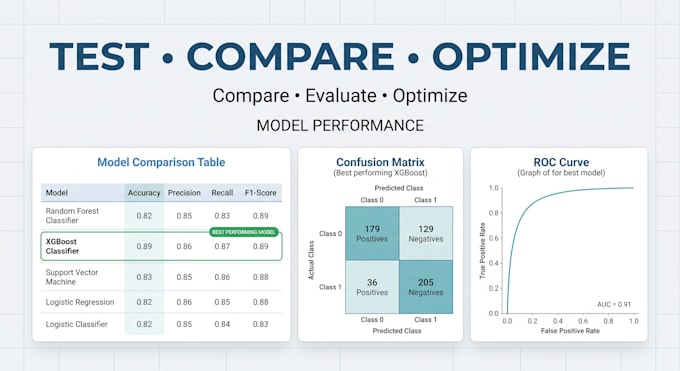
Je construis, entraîne et compare plusieurs modèles de classification sur vos données
pas seulement un algorithme populaire, puis je les évalue sur des données non vues en utilisant
les métriques adaptées à votre problème (précision, rappel, F1, ou autres).
Ce qui est inclus :
Je travaille avec des données numériques, catégoriques et textuelles, en classification binaire, multiclass ou multilabel.
Un exemple récent : j’ai construit un classificateur d’emails de phishing sur plus de 108 000 emails
(nom du projet : FoxLens, démo en direct sur Streamlit). Plutôt que de me contenter de rapporter
la précision seule, je l’ai testé en profondeur, identifié une faiblesse réelle (une dépendance excessive
à la présence de liens) remontée aux données d’entraînement, et je l’ai documentée publiquement
avec la même rigueur que j’applique à chaque projet : un modèle fonctionnel, une évaluation significative, et un compte rendu honnête de ses limites potentielles.
Besoin de déploiement ou d’intégration API ? Je peux en discuter séparément.


Expertise:
Classification
•
Analyse prédictive
Langage de programmation:
Python
•
Autres
Frameworks:
Scikit-learn
•
Panda
•
Autres
Outils:
Jupyter Notebook
•
Excel
Traduction automatique
De quoi avez-vous besoin de ma part pour commencer ?
Veuillez fournir votre jeu de données (CSV, Excel ou autre format supporté), une brève description du problème de classification et le résultat attendu. Si vous avez déjà une colonne cible ou des exigences spécifiques, incluez-les également.
Pouvez-vous travailler avec des données numériques et textuelles ?
Oui. Je peux créer des solutions de classification pour des données numériques, catégoriques et textuelles, en fonction de la structure et des besoins de votre projet.
Quels types de problèmes de classification gérez-vous ?
Je peux traiter des problèmes de classification binaire, multiclass et multilabel. La méthode appropriée dépend de votre jeu de données et de votre objectif.
Pouvez-vous améliorer ou optimiser un modèle existant ?
Oui. Si vous avez déjà un modèle de classification, je peux l’évaluer, identifier ses faiblesses, ajuster ses paramètres et le comparer avec d’autres approches adaptées.
Vais-je recevoir le code source et le modèle entraîné ?
Oui. Vous recevrez le code source Python ainsi que le modèle ou pipeline entraîné pour votre projet, accompagnés des résultats pertinents et des instructions pour l’utiliser.
Pouvez-vous déployer le modèle ou l'intégrer dans une API ?
Oui, le déploiement et l’intégration API peuvent être fournis pour les projets qui en ont besoin. Veuillez préciser vos exigences de déploiement pour que je puisse déterminer la portée appropriée et proposer une offre personnalisée si nécessaire.
Pouvez-vous travailler avec de grands ensembles de données ou des projets complexes ?
Je peux travailler avec des ensembles de données de petite à moyenne taille dans le cadre de ce service. Les ensembles de données plus volumineux, les pipelines complexes ou les projets nécessitant des ressources informatiques importantes peuvent nécessiter une offre personnalisée.