Parcourir les catégories
Français
$
USD
Connectez votre assistant IA à Fiverr



Traduction automatique
Vous avez besoin d'un scraper web rapide et fiable ou d'un pipeline d'extraction de données automatisé ? Vous êtes au bon endroit !
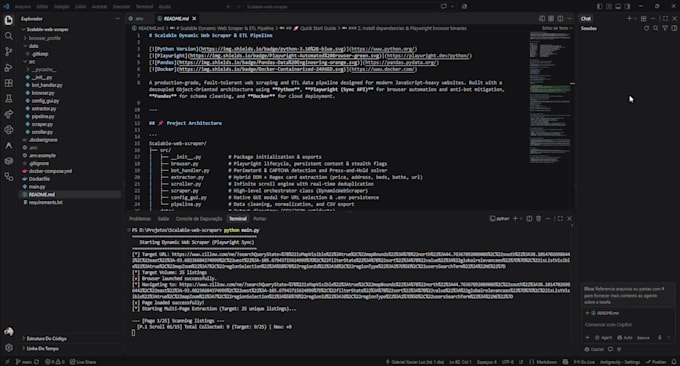
Je conçois des scrapers web de niveau production en Python en utilisant Playwright, Pandas et Docker. Contrairement aux scripts basiques qui se cassent sur les sites modernes, mes solutions gèrent les pages dynamiques complexes, les flux à défilement infini et les protections anti-bot.
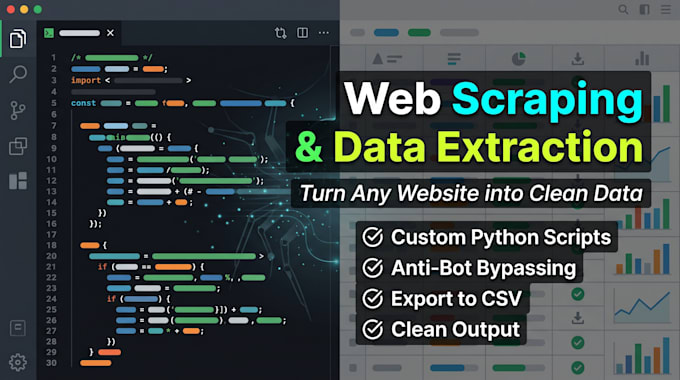
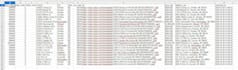
Ce que je livre : Scraping dynamique JS : applications monopages, défilement infini et éléments chargés paresseusement. Mitigation Anti-Bot & CAPTCHA : contourne PerimeterX, Cloudflare et les overlays de challenge grâce à des cookies persistants et des mécanismes de navigateur humanisés. Nettoyage automatisé des données (Pandas) : normalise le texte brut en nombres propres, sépare les adresses et supprime les doublons. Parcours multi-pages : pagination automatisée pour extraire des jeux de données volumineux. Formats propres : CSV prêt Excel, JSON ou Google Sheets. Docker prêt : déploiement conteneurisé en 1 clic pour PC locaux ou serveurs cloud (AWS/GCP).
Cas d'utilisation : annonces immobilières, tarification E-commerce, annuaires B2B.
️Veuillez me contacter avec l'URL cible et vos exigences avant de passer commande !
Python Developer, Automation and Data Processing
Langues
Traduction automatique
Traduction automatique
Pourquoi devrais-je vous envoyer un message avant de passer une commande ?
Chaque site possède une structure unique, un comportement JavaScript dynamique et des protections anti-bot. Passer en revue l’URL du site cible au préalable me permet de vérifier la faisabilité, de vérifier les champs de données requis et de proposer le package le plus rentable.
Pouvez-vous scraper des sites avec des CAPTCHA, Cloudflare ou PerimeterX ?
Oui ! J’utilise Playwright avec des sessions de navigateur persistantes, des mécanismes de souris humanisés et des configurations de drapeaux stealth spécialement conçues pour contourner les overlays de vérification des bots modernes et les défis dynamiques.
Dans quels formats recevrai-je les données extraites ?
Je fournis des données propres et formatées en CSV prêt Excel (encodage approprié pour éviter les erreurs de formatage), XLSX, JSON ou synchronisation directe avec Google Sheets. Vous recevez également l’intégralité du code source Python et la documentation.
Que dois-je faire pour exécuter ce scraper sur mon ordinateur ?
Vous avez deux options simples : vous pouvez l’exécuter localement avec Python standard, OU utiliser le setup Docker inclus (docker compose up) pour lancer l’ensemble du scraper en une seule commande sans configuration préalable ni installation de dépendances !
Ce scraper peut-il s’exécuter automatiquement sur un planning dans le cloud ?
Oui ! Avec le Dockerfile inclus, le scraper est prêt pour le cloud à 100 % et peut être déployé sur AWS, Google Cloud Run ou DigitalOcean pour fonctionner automatiquement selon des tâches cron planifiées (par exemple quotidiennement ou hebdomadairement).