Parcourir les catégories
Explorer
Fiverr Pro
Français
$
USD
Traduction automatique
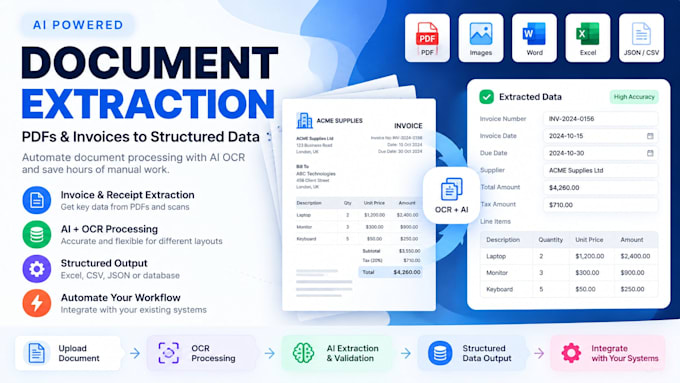
Extraction manuelle des informations depuis les factures, les PDFs, les reçus ou les documents numérisés ?
Je conçois des solutions d'OCR et de traitement de documents alimentées par l’IA qui transforment des documents non structurés en données propres et exploitables.
Que vous ayez besoin des données de facture dans Excel ou d’un flux de traitement de documents complet intégré à votre logiciel, je peux développer une solution adaptée à vos exigences.
Ce que je peux construire :
Pourquoi travailler avec moi ?
Je suis ingénieur logiciel avec plus de 8 années d’expérience dans la création d’applications professionnelles et d’intégrations. Je vais au-delà de l’extraction de texte. Votre solution peut valider les informations, gérer différents layouts de documents et signaler les enregistrements nécessitant une vérification manuelle.
Envoyez-moi un document échantillon et les champs à extraire. J’examinerai les exigences avant de commencer.
Senior Software Engineer
Langues
Traduction automatique
Traduction automatique
Quels types de documents pouvez-vous traiter ?
Factures, reçus, bons de commande, PDFs numérisés, formulaires et autres documents professionnels structurés ou semi-structurés. J’examine des échantillons pour évaluer la faisabilité.
Pouvez-vous extraire des données de PDFs scannés et d'images ?
Oui. L’OCR peut reconnaître le texte à partir de documents scannés et d’images. La précision dépend de la qualité du scan, de l’écriture, de la disposition et de la complexité du document.
Pouvez-vous convertir les informations PDF en Excel ou JSON ?
Oui. Les informations extraites peuvent être exportées vers Excel, CSV, JSON ou enregistrées dans une base de données selon le périmètre convenu.
Le système peut-il gérer différents formats de factures ?
Oui. Je peux développer une logique d’extraction pour plusieurs mises en page. Le nombre de formats pris en charge dépend de votre package et de la complexité des documents.
Pouvez-vous intégrer les données extraites à mon logiciel ?
Oui. Je peux intégrer le traitement des documents avec des REST APIs, des bases de données, des systèmes ERP et d’autres applications lorsque des interfaces compatibles sont disponibles.
Quelle est la précision de l'extraction de documents par IA ?
La précision varie selon la qualité et la complexité des documents. J’utilise des règles de validation et, lorsque c’est approprié, des contrôles de confiance et une revue humaine plutôt que de promettre une extraction parfaite.
Pouvez-vous traiter des documents commerciaux confidentiels ?
Je peux concevoir un flux de travail avec des contrôles d’accès appropriés et des pratiques de gestion des données. Toute exigence particulière en matière de confidentialité, de rétention ou de conformité doit être définie avant le développement.
