Parcourir les catégories
Explorer
Fiverr Pro
Français
$
USD

Traduction automatique
Souhaitez-vous ajuster des LLM open source tels que LLaMA 3, Mistral ou Qwen sur vos données d’entreprise privées ?
Je me spécialise dans l’ajustement fin paramètre- Efficace (PEFT) en utilisant les dernières technologies LoRA et QLoRA 4 bits avec Hugging Face TRL et PyTorch. Entraînez des modèles massifs sur des GPU grand public ou cloud sans perdre en précision !
Ce que je propose :
Préparation de jeux de données personnalisés : nettoyage, tokenisation et formatage des données brutes en prompts d’instructions JSONL.
Ajustement 4 bits QLoRA et LoRA : quantification NF4 et optimiseurs paginés pour un entraînement économique en mémoire.
Support multi-modèles : Meta LLaMA 3 / 3.2, Mistral 7B, Qwen 2.5, DeepSeek et Gemma.
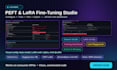
Interface Web interactive : un tableau de bord Streamlit personnalisé pour inspecter les données, visualiser les courbes de perte et tester les invites.
Fusion et déploiement : fusionner les adaptateurs LoRA en poids autonomes prêts pour Ollama, vLLM ou HF Hub.
Production prête : scripts d’inférence complets, documentation et gestion des erreurs.
️ Stack technique :
PyTorch | Hugging Face TRL | PEFT LoRA | bitsandbytes | Streamlit | vLLM | Ollama
Veuillez me contacter avant de commander afin que nous puissions discuter de la meilleure architecture de modèle pour vos données !
AI Automation and Custom Workflow Engineer Multi Agent
Langues
Traduction automatique


