Parcourir les catégories
Explorer
Fiverr Pro
Français
$
USD


Traduction automatique
Je vais analyser, comparer et optimiser vos prompts AI ou flux de travail LLM pour améliorer la fiabilité, la cohérence et la qualité des résultats.
Je vais examiner votre prompt existant, le tester avec des exemples d’entrées, identifier ses faiblesses ou ses schémas d’échec, et proposer des améliorations optimisées basées sur une évaluation structurée et une comparaison.
Selon le package choisi, les services peuvent inclure :
Ma méthode utilise un cadre d’évaluation propriétaire conçu pour mesurer les améliorations avec des résultats basés sur des preuves plutôt que sur des essais et erreurs de prompts.
Ce service convient pour :
L’objectif est d’aider vos systèmes IA à fonctionner de manière plus fiable face à des entrées du monde réel et des cas limites.
Notez que le nombre de cas de test est limité à 5 pour Basic, 20 pour standard et 50 pour premium.
Data Driven AI Evaluation and Optimization
Langues
Traduction automatique
Traduction automatique
Quels types de problèmes pouvez-vous aider à améliorer ?
Exemples incluent : Réponses incohérentes Hallucinations Mauvaise conformité aux instructions Raisonnement faible Problèmes de ton/style Formatage JSON invalide Verbosity excessive Problèmes de fiabilité selon les entrées
Fournissez-vous des rapports ?
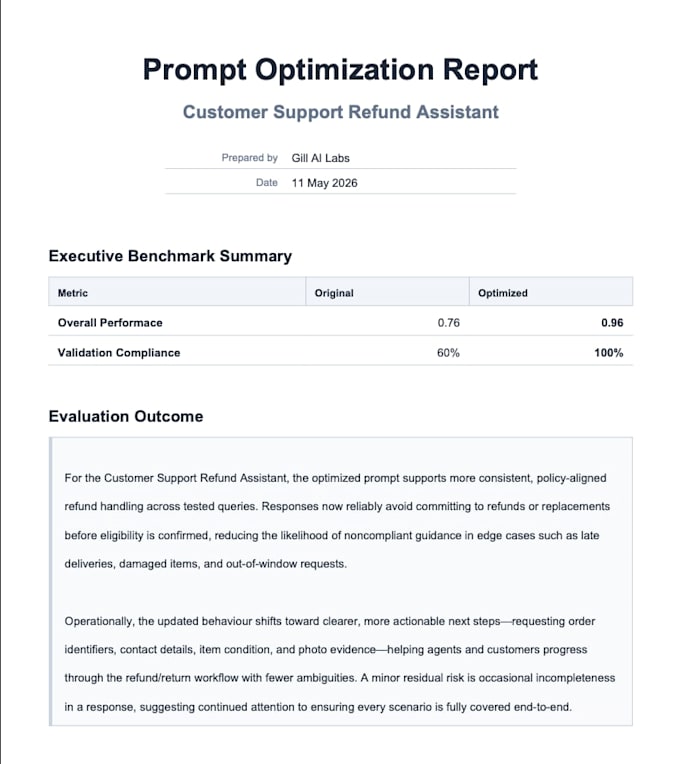
Oui. Selon le package choisi, les rapports peuvent inclure : Résultats de benchmarking Comparaisons avant et après Recommandations d’optimisation Résumé de l’évaluation Analyse de fiabilité
Pouvez-vous tester des prompts avec des jeux de données ou plusieurs scénarios ?
Oui. Les packages de niveau supérieur peuvent inclure des tests de benchmarking structurés sur plusieurs cas de test et cas limites.
Garantissez-vous des résultats parfaits avec l’IA ?
Aucun système IA ne peut être garanti de fonctionner parfaitement dans toutes les situations. L’objectif est d’améliorer significativement la fiabilité, la cohérence et la qualité globale des résultats en utilisant des méthodes d’évaluation et d’optimisation structurées.
Quels modèles d’IA prenez-vous en charge ?
Je peux travailler avec des prompts et flux de travail pour : ChatGPT d’OpenAI Claude d’Anthropic Google Gemini
De quoi as-tu besoin de moi ?
Veuillez fournir : Votre prompt ou flux de travail actuel L’objectif du système IA Exemples d’entrées et de sorties (si disponibles) Toute exigence de formatage, ton ou business Détails des problèmes rencontrés