Parcourir les catégories
Français
$
USD
Connectez votre assistant IA à Fiverr
Traduction automatique
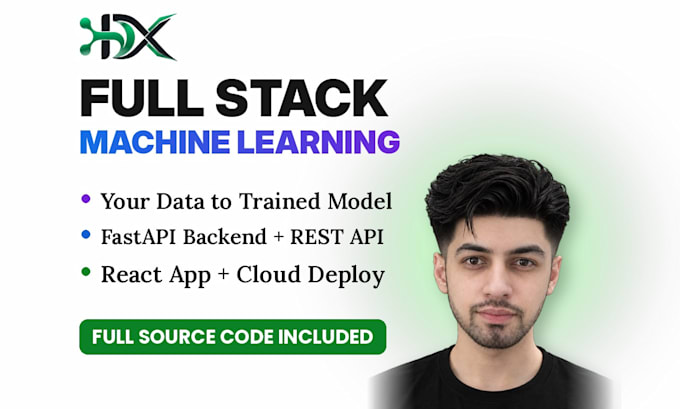
Besoin d’un produit IA complet, pas seulement d’un modèle ?
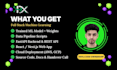
Je construis des systèmes d’apprentissage automatique complets de bout en bout : de vos données brutes à un modèle entraîné, une API backend et une application web que vos utilisateurs peuvent ouvrir.
Ce que je mets en place :
Parfait pour : les startups qui transforment une idée IA en produit opérationnel, les entreprises qui automatisent des prédictions ou la gestion de documents, et les équipes qui veulent un seul ingénieur pour l’ensemble de la stack.
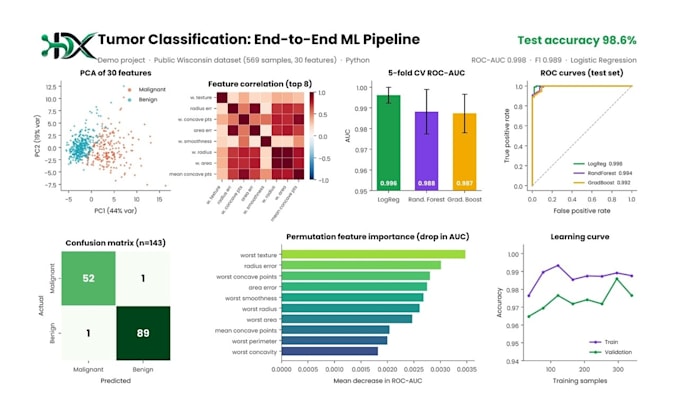
Preuves : ma démo ML de bout en bout atteint 98,6 % de précision (AUC 0,998), servie via une API et une application web en direct (voir la galerie).
Contactez-moi avant de commander. Partagez votre idée et vos données, et je confirmerai le bon package, le calendrier et exactement ce que vous obtiendrez."
AI Engineer for RAG Chatbots, AI Agents, LLM Fine Tuning and Computer Vision
Langues
Traduction automatique
Traduction automatique
Quelles données dois-je fournir ?
Vous fournissez du texte brut, des paires question-réponse, des conversations ou tout contenu spécifique au domaine. Un minimum de 500 échantillons est recommandé. Je m’occupe de tout le nettoyage, formatage et prétraitement.
Quels modèles pouvez-vous affiner ?
Des modèles open-source tels que LLaMA 3, Mistral, Phi-3, Falcon et la plupart des modèles Hugging Face. Je peux également utiliser le fine-tuning OpenAI lorsque votre cas d’utilisation le permet.
Le modèle sera-t-il déployé et prêt à l’emploi ?
Oui. Les packages Standard et Premium incluent un déploiement complet avec une API REST, vous permettant d’intégrer le modèle dans votre application immédiatement après livraison.
De combien de données ai-je besoin ?
Minimum 500 échantillons pour un ajustement de base. Pour de meilleurs résultats, 2000 à 10000 échantillons sont recommandés. Je peux également vous aider à générer des données d’entraînement synthétiques si nécessaire.
Puis-je utiliser le modèle à des fins commerciales ?
Oui. Vous obtenez la propriété complète des poids du modèle ajusté et de tous les scripts d’entraînement. L’utilisation commerciale est incluse dans tous les packages.