Parcourir les catégories
Explorer
Fiverr Pro
Français
$
USD
transition vers la bioinformatique
Vous cherchez un pipeline automatisé fiable et rapide pour traiter des séquences biologiques FASTA sans intervention manuelle ?
Je me spécialise dans la création de pipelines modulaires et reproductibles en Bash et Python, adaptés à l'extraction de séquences FASTA depuis NCBI et à l'analyse bioinformatique en aval.
### Ce que je propose dans cette service :
- Récupération automatisée de séquences NCBI : téléchargement en lot de séquences FASTA via les identifiants d'accès.
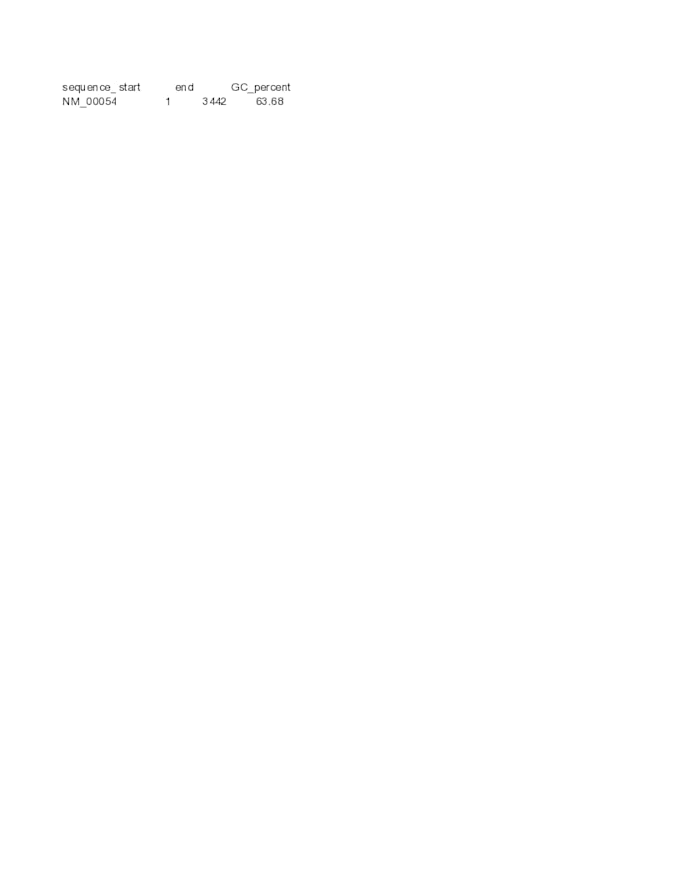
- Statistiques et métriques de séquences : calcul de la longueur totale, des pourcentages GC/AT, et des statistiques N50.
- Profilage GC par fenêtres : analyse détaillée du contenu GC sur des fenêtres glissantes.
- Manipulation de séquences : génération automatique de reverse complement et nettoyage des en-têtes FASTA.
- Export de données structurées : rapports TSV/CSV propres pour l'analyse en aval.
### Pourquoi choisir mon service ?
- Code propre et bien documenté : scripts Bash et Python modulaires conçus pour une réutilisation facile.
- Flux de travail optimisé pour le stockage : exécution efficace en ligne de commande sur des environnements Linux.
- Délai rapide et support complet : instructions détaillées pour une exécution fluide sur votre terminal.
N'hésitez pas à m'envoyer un message avec vos besoins spécifiques avant de passer commande !