Parcourir les catégories
Explorer
Fiverr Pro
Français
$
USD
Ingénieur Data expérimenté ! Spécialiste des pipelines de données ! Migration de données
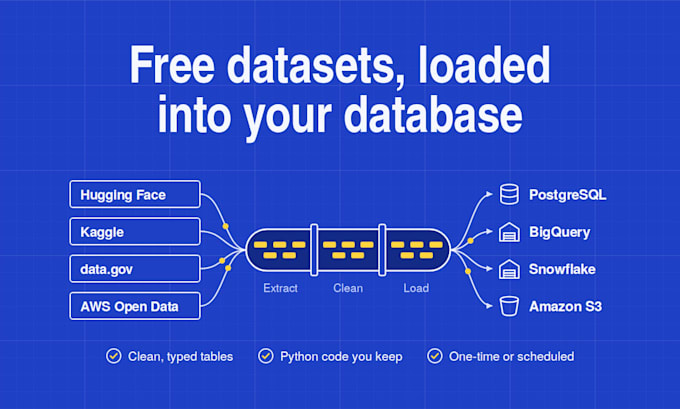
Vous avez besoin d’un dataset public dans votre propre base de données ? Je le récupérerai depuis Hugging Face, Kaggle ou toute autre source de données ouvertes, le nettoierai et le chargerai dans votre base de données, entrepôt de données ou stockage cloud, prêt à être interrogé.
Ce que je fais :
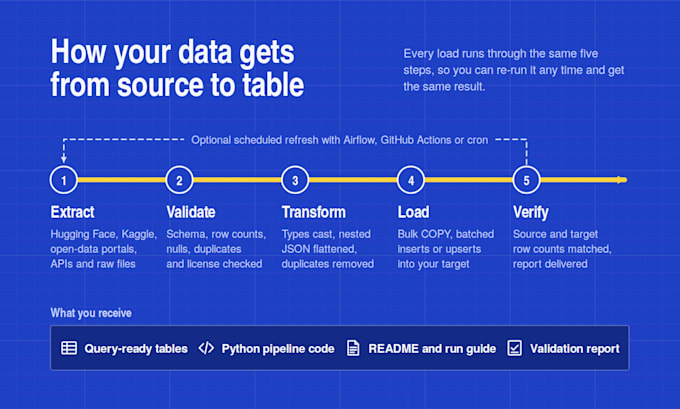
Extraction depuis Hugging Face, Kaggle, data.gov, AWS Open Data, BigQuery datasets publics, APIs, fichiers CSV, JSON ou Parquet
Nettoyage et transformation : correction des types de données, aplatir JSON imbriqué, supprimer les doublons et les lignes incorrectes
Chargement dans PostgreSQL, MySQL, SQL Server, MongoDB, Supabase, BigQuery, Snowflake, Redshift, Databricks, S3, GCS ou Azure
Streaming de grands datasets par lots, pour que la taille ne pose pas de problème
Chargements incrémentiels et actualisation programmée avec Airflow, GitHub Actions ou cron
Datasets textuels intégrés et chargés dans pgvector, Pinecone ou Qdrant pour l’IA et RAG
Vous obtenez :
- Des tables prêtes pour les requêtes dans votre stockage
- Un code Python propre et réutilisable
- Un README et un rapport de validation (comptage des lignes, schéma)
Je vérifie la licence de chaque dataset et signale toute restriction avant le chargement.
Vous ne savez pas quel package choisir ? Envoyez-moi le lien du dataset et votre destination avant de commander, je vous recommanderai une option.