Parcourir les catégories
Explorer
Fiverr Pro
Français
$
USD
Automatisation par IA et développeur full stack
Vous avez besoin d’un modèle d’apprentissage automatique qui transforme vos données en prédictions utiles ?
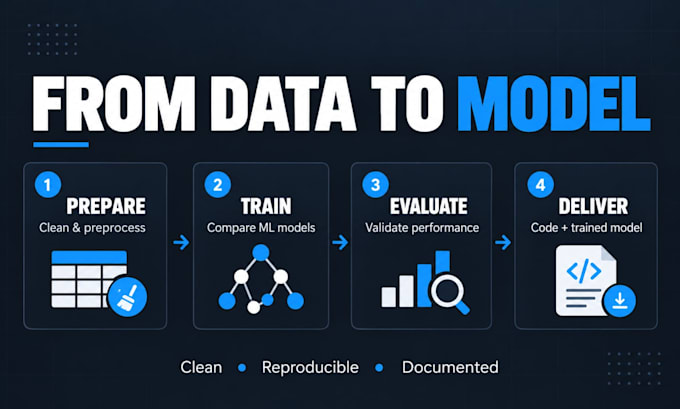
Je vais créer un modèle de classification ou de régression personnalisé en utilisant votre jeu de données structuré/tabulaire et fournir une évaluation claire, un code Python reproductible et des résultats documentés.
Je peux vous aider avec :
Veuillez me contacter avant de commander si votre jeu de données nécessite un nettoyage approfondi, plusieurs sources de données, du deep learning, NLP, prévision de séries temporelles, déploiement cloud ou traitement à grande échelle.
Les résultats dépendent de votre jeu de données et de la configuration d’évaluation, il n’est donc pas possible de garantir une précision ou des résultats commerciaux spécifiques.


Langage de programmation:
Python
•
R
•
MATLAB
•
SQL
Frameworks:
Scikit-learn
•
keras
•
PyTorch
•
Panda
•
Autres
Outils:
Jupyter Notebook
•
opencv
•
OpenNN
•
tensorflow
•
Excel
•
Colab
Traduction automatique
Sur quels types de problèmes d’apprentissage automatique pouvez-vous travailler ?
Ce service se concentre sur les problèmes supervisés utilisant des données structurées/tabulaires, principalement la classification et la régression. Veuillez me contacter d’abord pour la prévision de séries temporelles, NLP, vision par ordinateur, deep learning ou types de données inhabituels.
Qu’est-ce que la classification ?
La classification prédit une catégorie ou une classe, comme churn/non churn, fraude/non fraude, approuvé/rejeté, ou une catégorie parmi plusieurs classes possibles.
Qu’est-ce que la régression ?
La régression prédit une valeur numérique, comme un prix, un niveau de demande, un score, un montant de revenu ou une autre cible continue.
Quelles données dois-je fournir ?
Veuillez fournir un jeu de données structuré comme CSV, Excel ou un autre format tabulaire convenu, accompagné d’une description des colonnes et de la cible que vous souhaitez prédire.
Pouvez-vous nettoyer mon dataset ?
Le nettoyage est inclus dans les limites du package. Un nettoyage approfondi, la fusion de plusieurs sources de données, l’étiquetage manuel ou la reconstruction de jeux de données très incomplets peuvent nécessiter une offre personnalisée.
Quels algorithmes d’apprentissage automatique allez-vous utiliser ?
L’algorithme dépend de votre jeu de données et de la tâche de prédiction. Les approches appropriées peuvent inclure des modèles de régression, des arbres de décision, Random Forest, gradient boosting, XGBoost et d’autres méthodes classiques d’apprentissage automatique.
Pouvez-vous garantir une précision spécifique ?
Non. La performance du modèle dépend fortement de la qualité, de la quantité, de la pertinence, de l’équilibre et de la prévisibilité des données fournies. J’utiliserai des méthodes d’évaluation appropriées et rapporterai clairement les résultats obtenus.
Vais-je recevoir le code source ?
Oui. Vous recevrez le code Python reproductible ou le notebook inclus dans votre package, ainsi que les artefacts du modèle et la documentation pertinente.
Pouvez-vous déployer le modèle ?
Le package Premium inclut un prototype d’API d’inférence ou un script de prédiction par lot. Le déploiement complet dans le cloud, la surveillance, l’infrastructure évolutive et la gestion continue de MLOps sont des services séparés.