Parcourir les catégories
Explorer
Fiverr Pro
Français
$
USD


Traduction automatique
Description du service
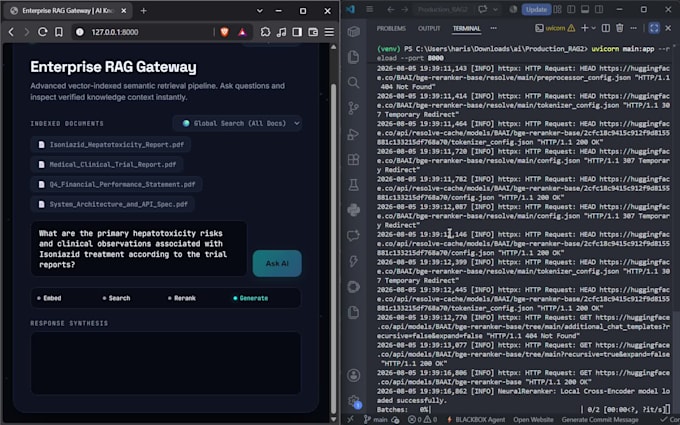
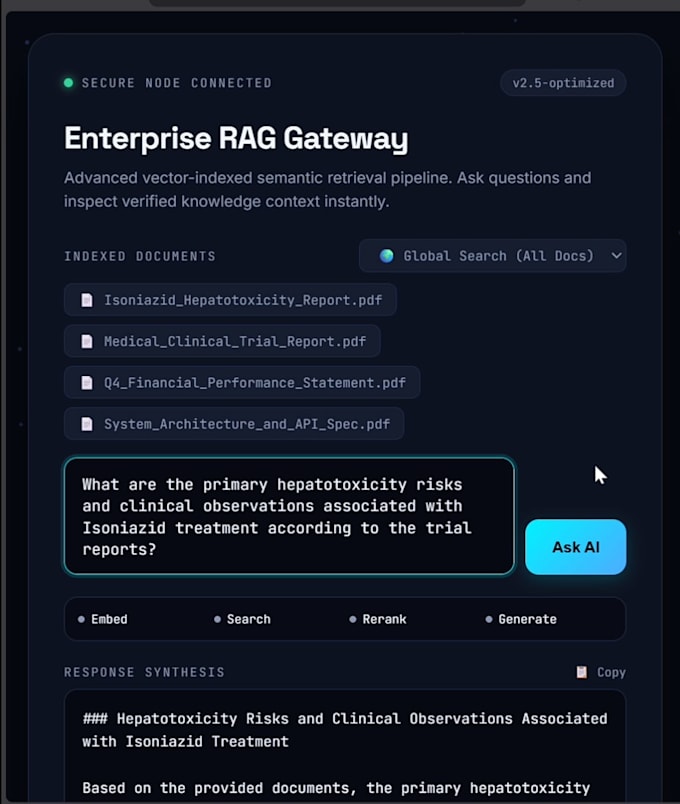
Souhaitez-vous une IA capable de dialoguer avec vos PDFs, documents ou bases de données avec précision ? Je vais créer un système RAG prêt pour la production pour votre entreprise...
Je me spécialise dans les architectures GenAI de production et les systèmes backend asynchrones utilisant Python, FastAPI, Vector DBs et LLMs (OpenAI, Groq, Llama 3).
️ Principales capacités :
Pile technologique :
Python | FastAPI | Qdrant | Pinecone | LlamaIndex | LangChain | OpenAI | Groq | Docker
Pourquoi me choisir ?
Discutons de votre projet ! Envoyez-moi un message avant de passer commande pour que nous puissions adapter l’architecture à vos besoins spécifiques en données.
Enterprise Rag and AI Systems Engineer
Langues
Traduction automatique
Traduction automatique
Q1 : Quelles sont les prérequis à fournir avant de commencer ?
Réponse : Vous devrez partager les spécifications de votre projet, des exemples de données/documents, et les clés API pour les fournisseurs LLM ou Vector DB choisis (par exemple, OpenAI, Groq, Pinecone). Si vous n’avez pas encore ces clés, je peux vous guider pour les configurer en toute sécurité dans un fichier .env.
Q2 : Mes données et clés API resteront-elles sécurisées pendant le développement ?
Réponse : Oui, absolument. Vos données, votre logique métier et vos identifiants restent 100 % confidentiels. Toutes les informations sensibles sont chargées via des variables d’environnement (.env) et ne sont jamais codées en dur ni partagées.
Q3 : Pouvez-vous gérer le parsing personnalisé de documents comme des tableaux complexes et des PDFs ?
Réponse : Oui. J’utilise des outils de parsing sensibles à la mise en page (comme LlamaParse) et des stratégies de découpage personnalisées pour extraire et structurer proprement tableaux, PDFs, Markdown et textes avant de les indexer dans la base vectorielle.
Q4 : L’application est-elle prête pour le déploiement cloud ?
Réponse : Oui. Chaque livrable inclut un code Python structuré, des endpoints FastAPI, un modèle .env.example, et un Dockerfile optimisé pour un déploiement instantané sur AWS, GCP, Azure ou tout serveur local.
Q5 : Que se passe-t-il si un fournisseur LLM tombe en panne ou atteint ses limites de débit ?
Réponse : Je construis une résilience intégrée avec des algorithmes de retry et une gestion de basculement multi-fournisseurs (par exemple, passer automatiquement de Groq à OpenAI si les limites de débit sont atteintes) pour assurer une haute disponibilité.