Parcourir les catégories
Explorer
Fiverr Pro
Français
$
USD
Développeur en IA générative RAG, LLMs, NLP, CV, solutions IA
Besoin d’une architecture NLP & RAG de niveau production ? Cessez de vous contenter de simples wrappers.
Bonjour, je suis un ingénieur en IA spécialisé dans le traitement avancé du langage naturel et les systèmes de récupération intelligents. Je ne me contente pas de connecter des clés API basiques ; je conçois des pipelines LLM complets, de niveau entreprise, optimisés pour la précision et la latence.
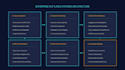
Principaux livrables opérationnels :
Mettons fin aux workflows legacy. Envoyez vos paramètres de données.

Traduction automatique
Quels formats de données votre pipeline RAG peut-il ingérer ?
Je conçois des pipelines d’ingestion de données robustes capables de traiter des données d’entreprise très peu structurées. Cela inclut des corpus PDF bruts, des matrices CSV, des tableaux JSON, et l’extraction directe depuis des bases relationnelles SQL ou NoSQL. Si vos données sont siloées, je construis la couche d’extraction pour les vectoriser.
Comment empêchez-vous le LLM de halluciner ou d’inventer des faits ?
J’utilise des architectures strictes de Retrieval-Augmented Generation (RAG). Le LLM est contraint mathématiquement à ne générer des réponses qu’à partir de chunks sémantiques extraits de votre base vectorielle privée, garantissant zéro hallucination.
Vos données d’entreprise propriétaires seront-elles utilisées pour entraîner des modèles publics ?
Une gouvernance totale des données est appliquée. Les API d’entreprise garantissent aucune conservation des données pour l’entraînement public. Pour une sécurité maximale, nous pouvons déployer des modèles open-source entièrement localement sur vos serveurs AWS/Azure isolés.
Utilisez-vous uniquement l’ingénierie de prompt ou construisez-vous une infrastructure réelle ?
Je suis architecte systèmes, pas rédacteur de prompts. Je construis une infrastructure backend complète : développement de nœuds FastAPI, configuration de bases NoSQL vectorielles (Chroma/Pinecone), logique de découpage, et liaison des boucles de récupération en natif.
Où déployez-vous l’application IA finale ?
Le déploiement s’adapte à votre stack. Je conteneurise le pipeline avec Docker pour une intégration CI/CD propre, ou déploie directement des nœuds d’inférence sur des environnements cloud de production évolutifs comme Amazon SageMaker ou Azure ML Studio.
Recevrai-je le code source complet et la documentation technique ?
Oui. Vous recevez le code source Python/FastAPI complet et non chiffré, les configurations d’indexation de la base de données, ainsi qu’une définition complète de l’architecture technique (TAD) décrivant tous les protocoles de vectorisation et de routage API.


