Parcourir les catégories
Explorer
Fiverr Pro
Français
$
USD
La bulle freelance
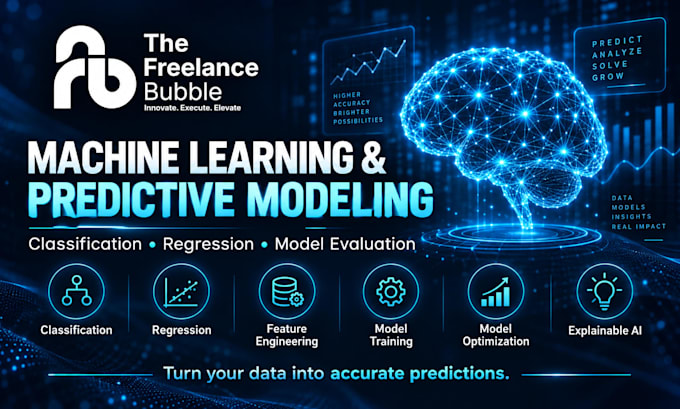
Je vais construire des modèles d'apprentissage automatique et de prédiction précis, interprétables et documentés de manière professionnelle, adaptés à vos données et à vos objectifs de projet.
Je peux travailler avec des ensembles de données de recherche, de santé, d'affaires, scientifiques et structurés pour transformer des données brutes en prédictions significatives et en insights exploitables.
Mes services incluent :
Je travaille avec Python, R, Scikit-learn, TensorFlow, PyTorch, XGBoost, Jupyter, Colab et RStudio.
Veuillez me contacter avant de commander pour le deep learning, les très grands ensembles de données, le déploiement en cloud, l'intégration API ou les workflows personnalisés.
Langage de programmation:
Python
•
R
•
MATLAB
•
SQL
•
Colab
Frameworks:
Scikit-learn
•
keras
•
PyTorch
•
Panda
•
Autres
APIs:
Autres
Outils:
Jupyter Notebook
•
tensorflow
•
Excel
•
MLflow
•
Stata
•
Colab
•
RStudio
Traduction automatique
Quels types de projets de machine learning pouvez-vous gérer ?
Je peux travailler sur la classification, la régression, le clustering, la détection d'anomalies, l'analyse prédictive, l'ingénierie de caractéristiques, les modèles d'arbres de décision et l'évaluation de modèles pour des ensembles de données de recherche, de santé, d'affaires et scientifiques.
Que dois-je fournir avant de commencer ?
Veuillez fournir votre ensemble de données, l'objectif du projet, la variable cible si applicable, le résultat souhaité et toute exigence ou question spécifique que vous souhaitez que le modèle aborde.
Quels langages et outils de programmation utilisez-vous ?
J'utilise principalement Python et R avec Scikit-learn, TensorFlow, PyTorch, XGBoost, Jupyter Notebook, Colab, RStudio, SQL et autres outils de data science.
Fournirez-vous le code source ?
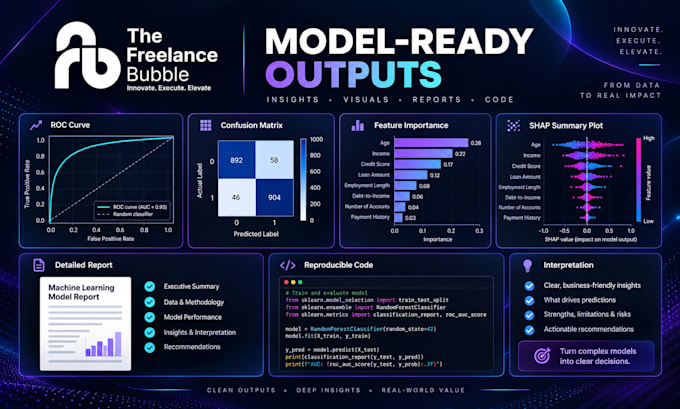
Oui. Le code source ou notebooks sont inclus selon le package choisi et seront organisés pour la reproductibilité et la revue.
Pouvez-vous comparer plusieurs modèles d'apprentissage automatique ?
Oui. Les packages Standard et Premium peuvent inclure plusieurs modèles, validation croisée, comparaison de modèles, optimisation et sélection basée sur des métriques de performance appropriées.
Proposez-vous une IA explicable ou une analyse SHAP ?
Oui. L'IA explicable, les valeurs SHAP, l'importance des caractéristiques et l'interprétation peuvent être inclus, notamment dans le package Premium ou via une offre personnalisée.
Pouvez-vous travailler avec des données de santé ou de recherche ?
Oui. Je peux analyser des ensembles de données biomédicales, de santé, de recherche et scientifiques. Veuillez vous assurer que toute donnée sensible est correctement anonymisée avant de partager.
Proposez-vous le déploiement du modèle ou l’intégration d’API ?
Oui, le déploiement en cloud et l'intégration API peuvent être ajoutés en options ou gérés via une offre personnalisée selon la complexité du projet.
Pouvez-vous garantir une précision spécifique du modèle ?
Non. La performance du modèle dépend de la qualité des données, de la taille de l’échantillon, de l’équilibre des classes, de la pertinence des caractéristiques et du problème de prédiction sous-jacent. Je privilégie une validation rigoureuse et un reporting transparent plutôt que des garanties irréalistes.
Dois-je vous contacter avant de commander ?
Oui, notamment pour les grands ensembles de données, le deep learning, les projets de santé, le déploiement, l'intégration API ou les exigences spécifiques en machine learning.