Parcourir les catégories
Explorer
Fiverr Pro
Français
$
USD
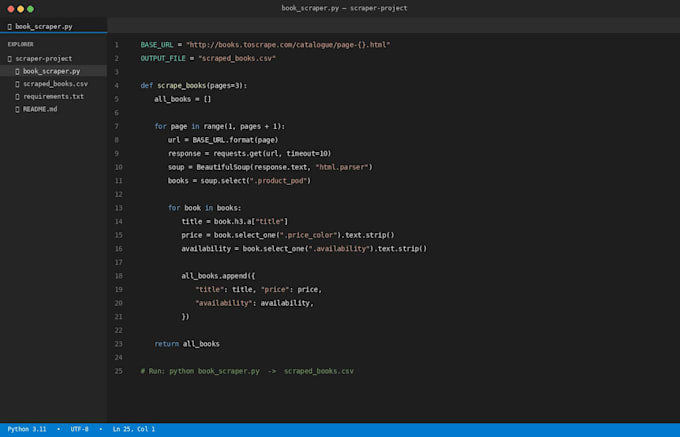
Vous avez besoin d'extraire des données d'un site web mais vous n'avez pas le temps de tout copier-coller manuellement ? Je crée des web scrapers personnalisés en Python qui extraient précisément les données dont vous avez besoin et les livrent propres et prêtes à l'emploi.
Ce que je peux scraper :
Listes de produits, prix et avis
Informations de contact et prospects (emails, numéros de téléphone)
Actualités, articles et contenus
Biens immobiliers et listes de répertoires
Toutes données structurées sur une page web publique
Outils que j'utilise : Python, BeautifulSoup, Scrapy, Selenium, Playwright. Je choisis l'outil adapté en fonction si le site est statique ou riche en JavaScript.
Formats de livraison : CSV, JSON ou Excel, selon ce qui convient à votre flux de travail.
Pourquoi travailler avec moi :
Je suis étudiant en ingénierie logicielle qui construit de véritables systèmes backend, pas seulement des scripts. J'ai créé une pipeline de données récupérant des images satellites en direct et des données météorologiques pour un hackathon soutenu par l'UE, et je développe actuellement un moteur de recommandation complet pour une plateforme de livres. Je mets autant de soin dans chaque scraper : code propre, portée honnête et communication claire.
Envoyez-moi le site et les données dont vous avez besoin avant de commander, je confirmerai si c'est faisable et signalerai tout ce qui pourrait poser problème (comme des murs de connexion ou une protection anti-bot lourde).

Technologie:
Python
•
scrapy
•
sélénium
•
Beautiful Soup
•
Playwright
Technique:
Automatisé(e)
Traduction automatique
Le web scraping est-il légal ?
Je ne scrape que des données accessibles publiquement et respecte le fichier robots.txt et les conditions d'utilisation de chaque site. Je ne scraperai pas de données personnelles protégées par login, de contenu soumis à copyright destiné à la revente, ou tout ce qui viole les conditions d'un site — je vous informerai dès le départ si votre demande dépasse cette limite.
Pouvez-vous récupérer les données de n’importe quel site Web ?
La plupart des sites, oui — mais certains utilisent une protection anti-bot lourde (CAPTCHAs, blocage d'IP) qui peut ralentir ou rendre le scraping impossible. Envoyez-moi l'URL avant de commander, je confirmerai si c'est faisable.
Dans quel format vais-je recevoir les données ?
CSV, JSON ou Excel — indiquez-moi votre préférence, sinon je partirai sur CSV par défaut.
Avez-vous besoin d'un accès login pour scraper un site ?
Seulement si les données sont derrière une connexion à laquelle vous avez légitimement accès. Je ne scraperai pas de données nécessitant des identifiants que je ne suis pas autorisé à utiliser.
Puis-je demander un nombre personnalisé de pages ou de champs non listés dans vos packages ?
Oui — contactez-moi avec les détails et je vous indiquerai la bonne option supplémentaire ou je vous enverrai une offre personnalisée.
Le scraper fonctionnera-t-il si le site change sa mise en page plus tard ?
Les scrapes ponctuels donnent les données telles qu'elles sont au moment de leur exécution. Si vous avez besoin d'un scraper qui fonctionne à long terme ou selon un calendrier, faites-le moi savoir — c'est quelque chose que nous pouvons définir séparément.
Combien de temps pouvez-vous livrer?
La livraison standard est de 3 à 6 jours selon le package. Besoin plus rapide ? Consultez l'option Livraison Ultra Rapide.