Parcourir les catégories
Français
$
USD
Connectez votre assistant IA à Fiverr
Développement web full stack, ingénierie des données, automatisation Python
Niveau 1
Répond à certains critères de performance et présente un fort potentiel sur la place de marché.
Des protections anti-bots, des pages dynamiques JavaScript ou des scrapers qui échouent freinent-ils vos opérations de données ?
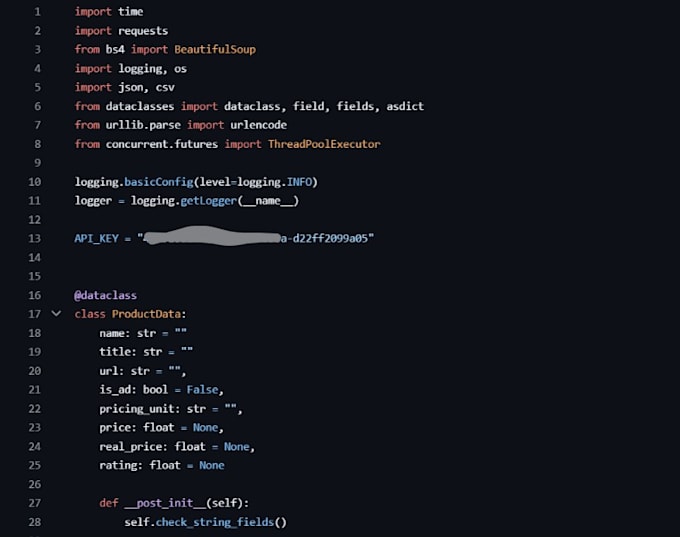
Je mets en place des solutions de scraping web Python résilientes et en production, utilisant Scrapy et Selenium, pour extraire des données propres et structurées à grande échelle sans intervention manuelle.
Ce que je construis :
Paire technologique :


Technologie:
Python
•
Excel
•
scrapy
•
sélénium
•
Beautiful Soup
Technique:
Automatisé(e)
Traduction automatique
Pouvez-vous scraper des sites nécessitant une connexion ou utilisant du JavaScript dynamique ?
Oui. J’utilise Selenium et Playwright pour gérer les sessions de connexion, les cookies, les flux d’authentification à deux facteurs (là où cela est possible) et le contenu dynamique chargé via React/Vue ou le défilement infini.
Comment évitez-vous les blocages IP et les limites de taux ?
Selon le package et l’architecture du site, je mets en œuvre une rotation aléatoire de l’agent utilisateur, des délais de requête personnalisés, un backoff exponentiel et une intégration avec votre fournisseur de proxy.
Dans quel format recevrai-je les données finales ?
Vous pouvez choisir CSV, XLSX (Excel), JSON, ou insertion directe dans des bases SQL (PostgreSQL, MySQL, SQLite). Tous les ensembles de données sont nettoyés, dédupliqués et validés selon le schéma avant livraison.