Parcourir les catégories
Explorer
Fiverr Pro
Français
$
USD

Traduction automatique
Votre équipe a déjà les réponses. Elles sont simplement enfouies dans des PDFs, wikis et tickets. Je crée un chatbot qui les trouve et affiche ses sources.
Je suis un ingénieur principal en données et IA avec plus de 9 ans d'expérience. J'ai construit des systèmes de données et de ML chez Amazon, Delivery Hero, Goldman Sachs et Orion, et je possède 13 certifications cloud, dont AWS Machine Learning Specialty et AWS Solutions Architect.
CE QUE JE CRÉE POUR VOUS
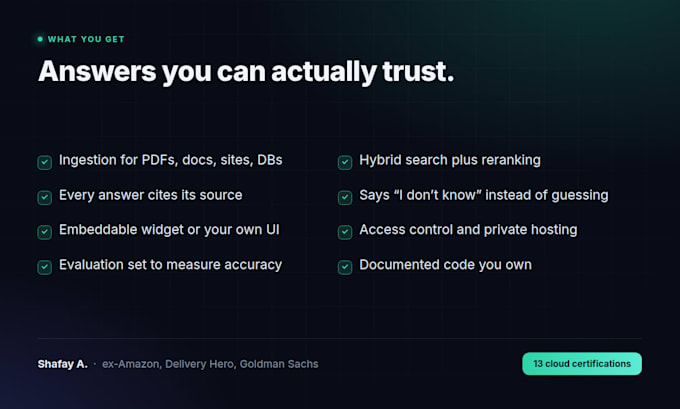
Ingestion pour PDFs, Word, Notion, Confluence, sites web et bases de données
Découpage, embeddings et recherche hybride avec reranking pour une récupération précise
Réponses avec citations, et un je ne sais pas honnête plutôt qu'une réponse inventée
Un widget web intégrable, un bot Slack ou Teams, ou votre propre interface utilisateur
Contrôle d'accès pour que les documents privés restent privés
Un ensemble d'évaluation pour mesurer la précision plutôt que de deviner
STACK
Python, LangChain, OpenAI, Claude, AWS Bedrock, pgvector, Pinecone, Qdrant, FastAPI, React
CE QUE VOUS RECEVEZ
Code source documenté que vous possédez, un déploiement fonctionnel et un appel de transfert de compétences.
Envoyez-moi quelques questions réelles que votre équipe pose et je vous dirai honnêtement si RAG y répondra bien.
Lead Data and AI Engineer, AWS Pipelines, LLM and RAG Apps
Langues
Traduction automatique
Traduction automatique
Quels types de fichiers et sources de données pouvez-vous indexer ?
PDF, Word, PowerPoint, Markdown, HTML, Notion, Confluence, Google Drive, SharePoint, sites web publics et bases de données SQL. Si une source dispose d'une API ou d'une exportation, elle peut presque toujours être indexée. Envoyez-moi un exemple et je confirmerai avant votre commande.
Comment empêchez-vous le chatbot de inventer des réponses ?
Chaque réponse est basée sur des passages récupérés et montre ses sources. Lorsque la recherche ne trouve rien de pertinent, le bot le dit plutôt que d'inventer. Je crée également un ensemble d'évaluation à partir de vos questions réelles pour que la précision soit mesurée, et non supposée.
Où mes données sont-elles stockées, et sont-elles privées ?
C'est votre choix. Je peux déployer entièrement dans votre propre compte AWS ou Azure, ou utiliser un modèle open auto-hébergé pour que rien ne quitte votre infrastructure. Vous gardez vos clés API et payez directement les fournisseurs, et je signe un NDA sur demande.