Parcourir les catégories
Explorer
Fiverr Pro
Français
$
USD
Copier-coller depuis les PDFs n’est pas scalable, et l’OCR générique déforme les tableaux. Les gigs d’entrée de données bon marché fonctionnent jusqu’à ce que vous ayez besoin d’un processus répétable, vérifiable et qui tourne chaque semaine sans vous.
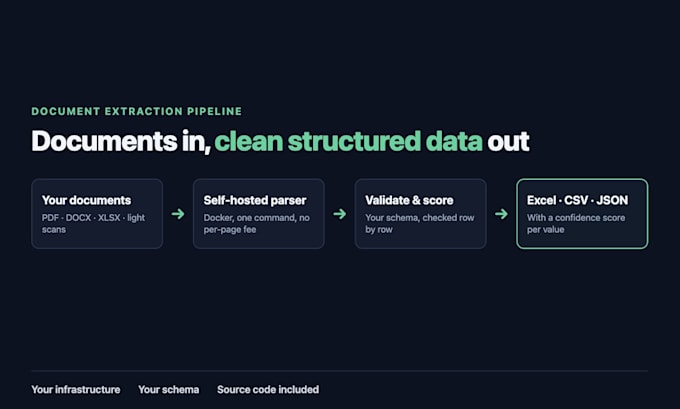
Moi, je construis la pipeline à la place : documents en entrée, données structurées propres en sortie, sur votre infrastructure.
CE QUE VOUS OBTENEZ
- Une pipeline que vous exécutez vous-même (Docker, une commande)
- Votre schéma, vos champs, validés sur chaque ligne
- Un score de confiance pour chaque valeur extraite
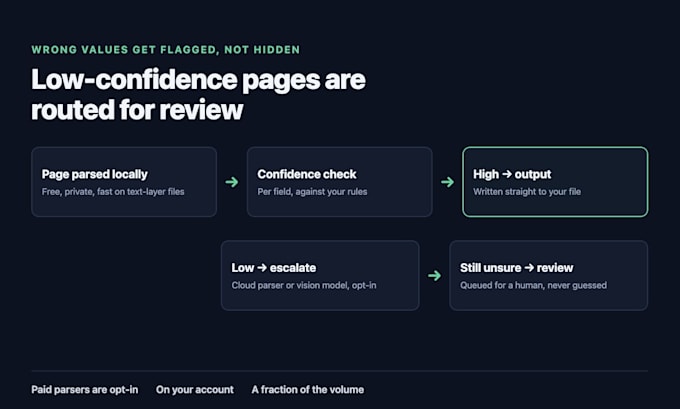
- Les pages à faible confiance sont dirigées pour révision, pas silencieusement incorrectes
- Sortie en Excel, CSV ou JSON
- Code source et documentation d’installation
POURQUOI AUTO-HÉBERGÉ
Le parser fonctionne localement : pas de frais par page, et vos documents ne quittent jamais votre infrastructure. Les parsers cloud payants ne sont utilisés que pour les pages qui en ont vraiment besoin — une fraction du volume, sur votre compte, à votre discrétion.
COMMENT JE TRAVAILLE
Commencez par le pilote. Envoyez 20-50 pages réelles. Je les traite et vous envoie un rapport écrit : ce qui a été extrait proprement, ce qui ne l’a pas été, et quels champs nécessitent des règles de révision. Ensuite, vous décidez.
EN PRINCIPE
PDF avec couche de texte, DOCX, XLSX, PPTX et scans légers. L’écriture manuscrite, les formulaires et les graphiques sont quotés séparément — il suffit de demander.
Envoyez 3-5 pages d’exemple et les champs dont vous avez besoin.
Technologie:
Excel
•
Python
Traduction automatique
En quoi cela diffère-t-il d’un gig d’entrée de données à 20 $ ?
Un gig d’entrée de données ne traite qu’une fois vos documents. C’est une pipeline que vous possédez et que vous pouvez relancer indéfiniment, avec des règles de validation et des scores de confiance pour voir quelles valeurs faire confiance. C’est un achat complètement différent.
Je paie par page ?
Pas pour le parser — il tourne sur votre propre machine, donc le volume de pages est gratuit. Seules les pages nécessitant un parser cloud ou un modèle de vision coûtent quelque chose, sur votre propre compte, et c’est vous qui décidez si vous souhaitez l’activer ou non.
Quelle précision pouvez-vous garantir ?
Aucun avant d’avoir vu vos documents, et soyez sceptique envers quiconque prétend le contraire. Les benchmarks des parsers publiés varient énormément et les résultats dépendent de vos mises en page spécifiques. Le pilote évalue cela d’abord sur vos pages réelles.
Mes documents quittent-ils mon infrastructure ?
Pas par défaut. Le parser est auto-hébergé. Les parsers cloud sont en option, page par page, et uniquement pour celles que le pipeline local considère comme à faible confiance. Si vous souhaitez zéro appel externe, indiquez-le et je le construirai ainsi.
Pouvez-vous traiter des documents scannés ?
Les scans légers, oui. Les scans lourds, l’écriture manuscrite et les formulaires sont possibles mais nécessitent un devis séparé. Ils sont vraiment plus difficiles, et je préfère les tarifer honnêtement plutôt que de sous-livrer.
Que se passe-t-il si le système se trompe sur une valeur ?
Les valeurs erronées sont signalées, pas masquées. Chaque valeur a un score de confiance, et les lignes à faible confiance sont dirigées pour révision plutôt que d’être silencieusement intégrées dans votre feuille de calcul.
Qui l’exécute après la remise ?
Vous. C’est un conteneur Docker plus votre code, avec la documentation d’installation. Une seule commande pour démarrer.