Parcourir les catégories
Français
$
USD
Connectez votre assistant IA à Fiverr
Ingénieur IA : apprentissage automatique, IA générative, optimisation
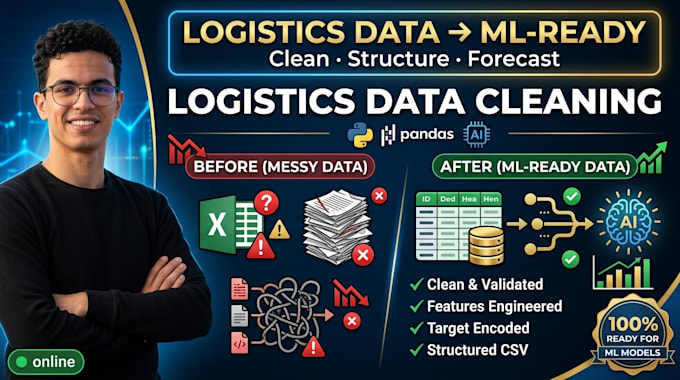
Des feuilles de calcul désordonnées vous empêchent-elles de former vos modèles ML ?
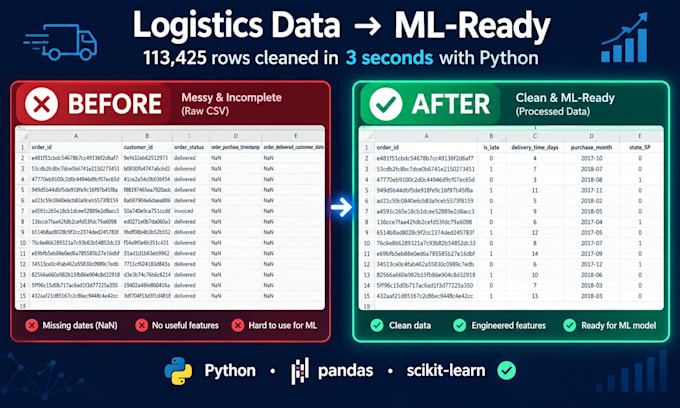
Des journaux de livraison non structurés, des enregistrements d’entrepôt incohérents et des valeurs d’inventaire manquantes peuvent compromettre la précision de votre Machine Learning. J’aide les entreprises logistiques et les équipes de données à transformer des données opérationnelles brutes et chaotiques en ensembles de données propres et prêts pour le ML.
Ce que je peux faire pour vos données logistiques :
Ce que vous recevrez :
Outils que j’utilise : Python, Pandas, NumPy, Scikit-Learn.
Contactez-moi avant de passer commande pour que nous puissions discuter de la taille de votre dataset et de vos objectifs spécifiques !
Traduction automatique
Quels formats de fichiers acceptez-vous ?
CSV, Excel (.xlsx, .xls), JSON, Parquet, et la plupart des formats tabulaires. Envoyez-moi simplement votre fichier et je confirmerai.
Que signifie "prêt pour ML" ?
Votre jeu de données sera prêt à être directement utilisé dans un modèle de Machine Learning : valeurs nettoyées, catégories encodées, caractéristiques normalisées et aucune donnée manquante.
Obtiens-je le code Python ?
Oui ! Chaque commande inclut le script Python entièrement commenté (Pandas, numpy, scikit-learn) pour que vous puissiez reproduire le processus vous-même.
Comment gérez-vous la confidentialité de mes données ?
Vos données sont 100% confidentielles. Je ne partage, ne stocke ni ne réutilise jamais vos fichiers. Je peux signer un NDA si nécessaire.
Pouvez-vous gérer de grands jeux de données logistiques ?
Oui, jusqu'à 1 million de lignes selon le package. Contactez-moi d'abord pour des jeux de données de plus de 100 000 lignes.