Parcourir les catégories
Explorer
Fiverr Pro
Français
$
USD
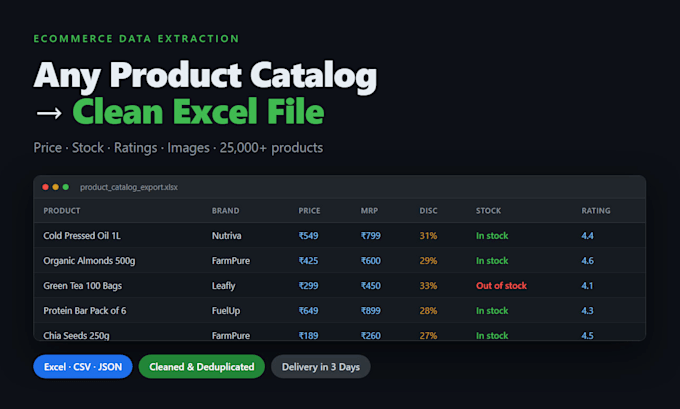
Spécialiste en extraction de données et web scraping
Vous avez déjà essayé un scraper et vous avez été bloqué ? C’est le service que je propose.
La plupart des vendeurs peuvent gérer une page statique simple. Je travaille sur des sites qui luttent activement contre les limites de taux, utilisent des tokens rotatifs, des requêtes API signées, une authentification basée sur la session, et des pages riches en JS qui ne s’affichent qu’après connexion.
Ce que je gère :
Ce que vous obtenez : CSV / Excel / JSON propres, le script fonctionnel, et une courte note sur comment le relancer.
J’ai créé des crawlers en production pour de grandes plateformes de commerce électronique et de quick-commerce, y compris celles avec protection WAF et schémas de requêtes signées. Si un site a surpassé votre précédent développeur, envoyez-moi l’URL avant de commander et je vous dirai honnêtement si c’est faisable.


Technologie:
JavaScript
•
Python
•
scrapy
•
sélénium
•
Playwright
Technique:
Automatisé(e)