Parcourir les catégories
Explorer
Fiverr Pro
Français
$
USD
Ingénieur de données
Vous faites face à des requêtes lentes dans BigQuery, des modèles dbt cassés ou des jobs Spark non optimisés ?
Je suis un ingénieur de données senior (certifié associé Databricks) avec plus de 5 ans d’expérience dans la construction et l’optimisation d’architectures de données cloud évolutives (GCP, Databricks, BigQuery). Je me spécialise dans la transformation de pipelines de données complexes, lents et coûteux en workflows rapides, efficaces et économiques.
Ce que je peux faire pour vous :
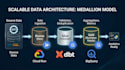
- dbt & entreposage de données : construire et refactoriser des modèles dbt selon l’architecture Medallion (Bronze, Silver, Gold), optimiser les requêtes SQL, et configurer les exécutions Cloud Run / Control-M / Airflow.
- PySpark & Databricks : déboguer, refactoriser et accélérer les pipelines ETL batch avec Spark (Scala/Python).
- Architecture cloud GCP : mettre en place des pipelines évolutifs avec BigQuery, Cloud Run et Airflow/Composer.
- Optimisation de bases de données et requêtes : réduire les coûts de traitement et les temps d’exécution dans BigQuery/Snowflake.
Pourquoi travailler avec moi ?
- Expertise certifiée : ingénieur de données certifié Databricks & Azure.
- Code de haute qualité : pratiques d’ingénierie de données propres, modulaires et faciles à maintenir.
- Communication claire et directe : disponible en anglais et en espagnol.
NOTE : Contactez-moi avec vos besoins avant de passer commande.

Outils et plateformes:
Google Cloud Dataflow
•
Apache NiFi
•
Autres
Traduction automatique
Acceptez-vous des commandes personnalisées à long terme ?
Oui, mais uniquement pour des micro-tâches ou du conseil à temps partiel. Veuillez m’envoyer un message d’abord pour discuter des détails.
Que dois-je fournir avant de commencer ?
Accès à l’environnement cloud (ou données/code anonymisés) et une description claire du résultat attendu ou des logs d’erreur.
Pouvons-nous planifier un appel pour discuter du projet ?
Oui, via la fonction appel vidéo de Fiverr une fois la commande ou la demande lancée.


