Parcourir les catégories
Français
$
USD
Connectez-vous à votre IA
Ingénieur en données cloud
Vous avez du mal avec des flux de données désordonnés, manuels ou peu fiables ? Je crée des pipelines de données propres et automatisés
qui fonctionnent simplement de manière fiable, selon le calendrier, sans surveillance constante.
Je suis un ingénieur en données travaillant professionnellement sur des pipelines ETL basés sur Spark pour des données financières,
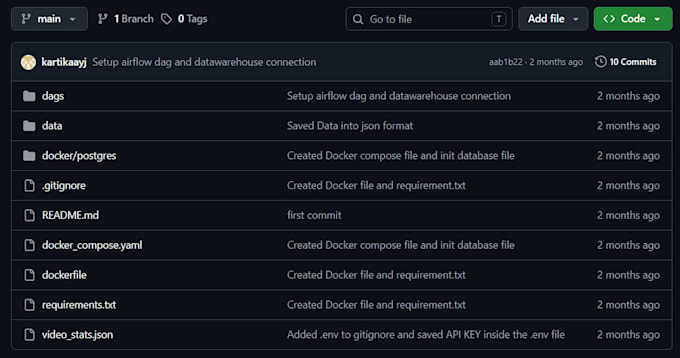
avec une expérience pratique en Python, PySpark, Airflow, PostgreSQL et AWS.
CE QUE JE PEUX CONCEVOIR POUR VOUS :
pipelines ETL/ELT (sources API, bases de données ou fichiers)
Airflow DAGs pour des workflows planifiés et automatisés
Validation des données et contrôles de qualité (vérifications de null, comptages d’enregistrements, vérifications de schéma)
pipelines PySpark pour le traitement de grands ensembles de données
Entrepôts de données PostgreSQL/MySQL et pipelines de reporting
Nettoyage et optimisation de pipelines existants lents ou peu fiables
POURQUOI TRAVAILLER AVEC MOI :
- Je crée des pipelines destinés à fonctionner en production, pas seulement une fois
- Communication claire : je poserai les bonnes questions avant d’écrire une ligne de code
- Code documenté, prêt à être transmis (README + commentaires), pas une boîte noire
Vous n’êtes pas sûr de ce dont vous avez besoin ? Envoyez-moi un message avec votre source de données et votre objectif final, je vous dirai
honnêtement ce qui est réaliste et comment je m’y prendrais.