Parcourir les catégories
Explorer
Fiverr Pro
Français
$
USD
Spécialiste en Machine Learning et NLP
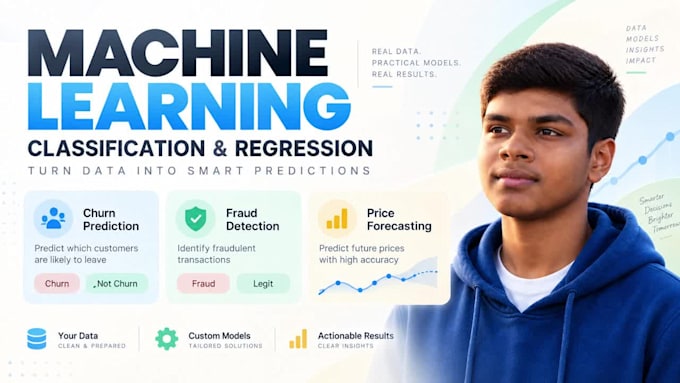
Vous avez besoin d’un modèle d’apprentissage automatique fiable pour la classification, la régression ou la prédiction ?
Portfolio : https://kawsar-portfolio-kawsar07ahmmed0712-5454.vercel.app/
Je crée des solutions d’apprentissage automatique propres et pratiques pour des données structurées et tabulaires en utilisant Python.
Ce que je peux faire :
Outils que j’utilise :
Scikit-learn, XGBoost, LightGBM, CatBoost, Pandas, NumPy, Jupyter Notebook et TensorFlow selon les besoins.
Vous recevrez un code source propre, un modèle entraîné, des résultats d’évaluation, des visualisations et une documentation claire. Les packages Standard et Premium incluent un réglage plus approfondi et une comparaison de modèles, tandis que le package Premium peut également inclure une intégration API Flask.
Veuillez m’envoyer un message avec votre dataset et votre objectif de projet avant de commander afin que je puisse vous recommander le bon package.
Merci,
Kawsar Ahmmed




Langage de programmation:
Python
•
SQL
•
Colab
Frameworks:
Scikit-learn
•
keras
•
PyTorch
•
Panda
•
Autres
Outils:
Jupyter Notebook
•
tensorflow
•
Excel
•
Colab
Traduction automatique
Avec quels types d’ensembles de données pouvez-vous travailler ?
Je travaille principalement avec des jeux de données structurés ou tabulaires tels que des fichiers CSV et Excel contenant des caractéristiques numériques ou catégoriques. Si vous n’êtes pas sûr que votre dataset soit adapté, veuillez m’envoyer un message avant de commander.
Dois-je savoir si mon problème concerne la classification ou la régression ?
Non. Expliquez simplement ce que vous souhaitez prédire, et je vais examiner votre variable cible et recommander l’approche d’apprentissage automatique la plus adaptée.
Comment choisissez-vous le bon modèle d’apprentissage automatique pour mes données ?
Je compare les algorithmes appropriés en fonction de votre dataset, du type de problème et des métriques d’évaluation. Selon le projet, j’utilise des modèles tels que la régression logistique ou linéaire, la forêt aléatoire, XGBoost, LightGBM, CatBoost, SVM ou KNN.
Que vais-je recevoir avec ma commande ?
Selon le package, vous recevrez un code source Python propre, un Jupyter Notebook, un workflow de prétraitement, un modèle entraîné, des résultats d’évaluation, des visualisations pertinentes et la documentation du modèle.
Pouvez-vous travailler avec des jeux de données désordonnés ou déséquilibrés ?
Oui. Je peux gérer des problèmes courants tels que les valeurs manquantes, les caractéristiques catégoriques, la mise à l’échelle, l’ingénierie des caractéristiques et le déséquilibre des classes en utilisant des techniques de prétraitement appropriées.
Pouvez-vous garantir une précision ou un score de performance spécifique ?
Aucune précision fixe ne peut être garantie car la performance du modèle dépend de la qualité, de la taille, de l’équilibre et des informations prédictives du dataset. J’utiliserai des méthodes de validation, des métriques et des optimisations appropriées pour obtenir un résultat fiable.
Proposez-vous une intégration API pour le modèle entraîné ?
Oui. Le package Premium peut inclure une intégration API Flask afin que le modèle entraîné puisse accepter des entrées et retourner des prédictions via une API. Le déploiement sur le cloud n’est pas inclus sauf accord séparé.