Parcourir les catégories
Explorer
Fiverr Pro
Français
$
USD
Développeur Python, expert en web scraping et analyse de données
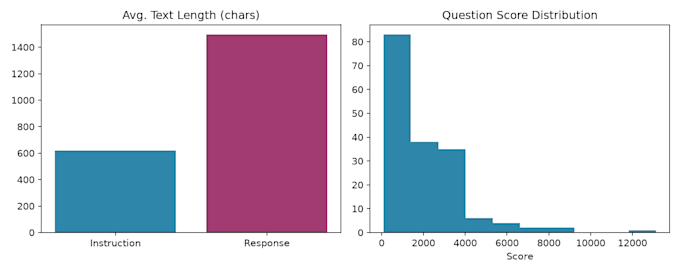
Vous avez besoin de données Q&A propres et structurées pour affiner ou entraîner un modèle d'IA/LLM ?
Je crée des pipelines de collecte de données qui extraient des paires question-réponse à partir de sources publiques basées sur des API (pas de scraping HTML fragile), nettoient le texte, filtrent le contenu de faible qualité ou contenant des PII, et livrent un JSONL d'instructions/réponses prêt à l'emploi, dans le format exact utilisé pour affiner des modèles comme GPT et Llama.
Ce que vous obtenez :
J'utilise des API publiques officielles plutôt que de scraper des sites qui l'interdisent (comme Reddit/Quora), pour que votre dataset soit propre, légal et fiable.
Indiquez-moi votre sujet/domaine et le nombre d'enregistrements dont vous avez besoin, et je confirmerai la portée avant que vous passiez commande.

Expertise:
Autres
Langage de programmation:
Python
Outils:
Jupyter Notebook
Traduction automatique
De quelles sources collectez-vous ?
APIs publiques documentées (par exemple Stack Exchange) qui permettent explicitement ce type de collecte — pas de plateformes de scraping qui l'interdisent.
Dans quel format les données sont-elles livrées ?
JSONL (paires instruction/réponse), le format standard pour l'affinement de LLM. CSV/JSON également disponible sur demande.
Pouvez-vous faire un sujet/domaine personnalisé ?
Oui — envoyez-moi votre sujet et le nombre d'enregistrements souhaité avant de commander pour que je puisse confirmer la faisabilité.