Parcourir les catégories
Explorer
Fiverr Pro
Français
$
USD
Ingénieur en vision par ordinateur, YOLO et déploiement en temps réel
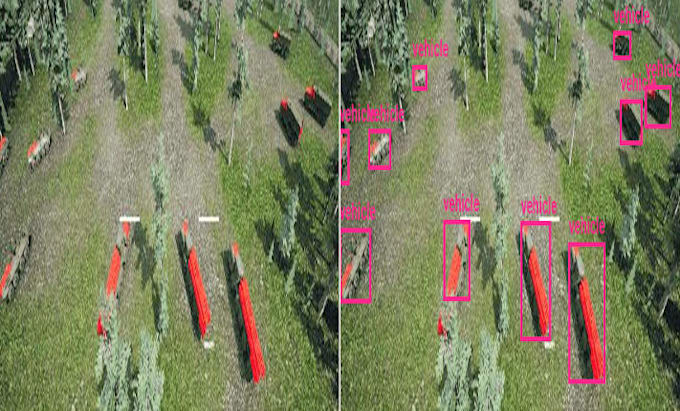
Annotation précise de boîtes englobantes et de polygones pour les données d'entraînement en vision par ordinateur, livrées dans le format attendu par votre pipeline.
Je suis ingénieur en vision par ordinateur, pas un contractant en étiquetage. Cela se voit dans les cas limites : objets occultés, frontières de classe ambiguës et instances proches de la limite de résolution. J'étiquette de la manière dont un modèle doit être appris, et je signale les décisions que vous devriez prendre plutôt que de deviner à votre place.
CE QUE VOUS RECEVEZ
Boîtes englobantes ou masques de segmentation polygonale
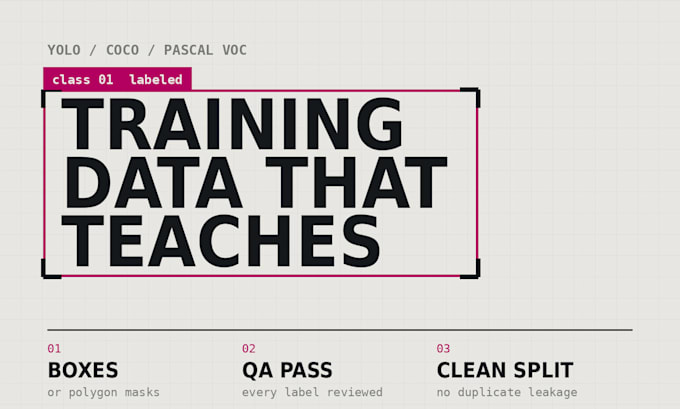
Export en YOLO, COCO JSON ou Pascal VOC XML
Résumé de la répartition des classes pour voir les déséquilibres avant l'entraînement
Notes sur les cas ambigus et comment je les ai résolus
Les packages Standard et Premium incluent une revue QA en deuxième passage pour chaque annotation.
Le package Premium comprend une séparation sûre pour l'entraînement, la validation et le test, regroupée pour que les images proches en doublon ne soient pas dans les deux ensembles et n'influent pas sur votre score de validation.
L'extraction de frames vidéo est incluse sans coût supplémentaire. Envoyez la vidéo brute et votre taux d'échantillonnage.
Contactez-moi avec le nombre d'images et la liste des classes pour un devis précis.

Technique:
Manuel
Type d'identification:
Image
•
Vidéo
Traduction automatique
Comment assurez-vous la cohérence de l'étiquetage sur des milliers d'images ?
Je rédige une courte ligne directrice d'étiquetage avant de commencer, couvrant ce qui compte comme une instance, comment gérer l'occultation et la taille minimale des objets, puis je vous l'envoie pour approbation. La cohérence vient du fait de décider des règles une fois pour toutes, dès le départ, et non au cas par cas.
Pouvez-vous annoter des vidéos ?
Oui. Envoyez la vidéo brute et votre taux d'échantillonnage, et j'extrais les frames sans coût supplémentaire. Les frames d'un même clip sont proches en doublon, je les regroupe donc lors de la séparation pour éviter qu'elles ne soient dans les deux ensembles, entraînement et validation.
Mes données sont-elles gardées confidentielles ?
Oui. Vos données sont utilisées uniquement pour votre projet, stockées localement pendant le travail, puis supprimées sur demande après livraison. Je suis prêt à signer un NDA avant que vous n'envoyiez quoi que ce soit.
Que faire si je ne suis pas d'accord avec certaines étiquettes ?
Envoyez-moi les fichiers spécifiques et ce que vous auriez fait différemment. Je les révise et mets à jour la ligne directrice pour que la même décision soit appliquée au reste de l'ensemble. Les révisions sont incluses dans tous les packages.