Parcourir les catégories
Explorer
Fiverr Pro
Français
$
USD
Spécialiste en IA, ML et science des données, annotation de données, Python, CVAT
Un modèle prédictif est inutile s'il ne vit que dans un Jupyter Notebook. Vous avez besoin d'une IA prête pour la production.
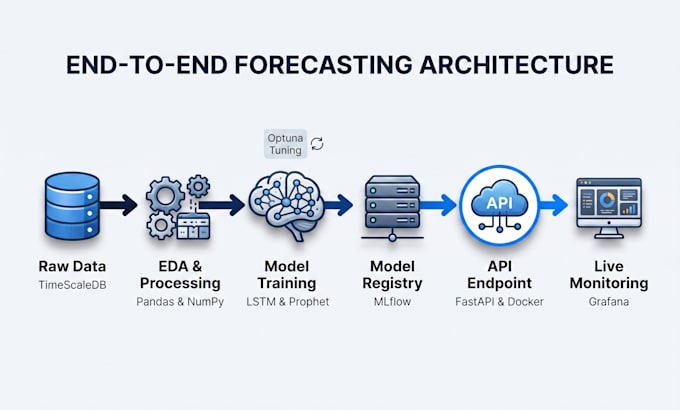
Au lieu de simplement effectuer des prévisions statistiques de base, je me spécialise dans la transformation de données historiques brutes en moteurs de prévision évolutifs et déployés. De l’optimisation des hyperparamètres aux API en temps réel, je construis des pipelines de bout en bout prêts à être intégrés dans votre logique métier, que vous prévoyiez des ventes au détail ou des données de capteurs IoT à haute fréquence.
Prévisions avancées et apprentissage automatique :
Le pipeline de production (la vraie valeur) :
IMPORTANT : chaque jeu de données et objectif métier est unique. Merci de me contacter avant de passer commande.


Traduction automatique
Mes données commerciales propriétaires seront-elles confidentielles ?
Absolument. Je traite toutes les données clients avec la plus grande confidentialité. Je suis prêt à signer un NDA avant de commencer. Une fois le projet terminé et le pipeline remis, toutes les données brutes sont définitivement supprimées de mes environnements locaux.
Dans quel format doivent être mes données, et quelles sont les exigences ?
J'accepte CSV, Excel, JSON ou des dumps de bases de données SQL. Pour la prévision de séries temporelles, votre jeu de données doit contenir au moins deux colonnes : un indicateur clair de temps/date chronologique et la variable cible que vous souhaitez prévoir (par exemple, ventes quotidiennes, charge horaire du serveur ou prix des actions).
Pouvez-vous garantir une précision de 100 % pour les prévisions futures ?
Aucun data scientist honnête ne peut garantir une précision parfaite à l'avenir, car des événements du monde réel (comme des crashs de marché soudains ou des tendances virales) introduisent du bruit imprévisible. Cependant, j'utilise une validation croisée rigoureuse et un réglage des hyperparamètres (via Optuna) pour assurer mathématiquement que le modèle fournit la meilleure précision possible.
Hébergez-vous le modèle pour moi ou dois-je l'héberger ?
Mon package Premium vous fournit une configuration Docker entièrement conteneurisée. Cela signifie que je construis le package logiciel complet et déployable, que vous (ou votre équipe d'ingénierie) pouvez exécuter instantanément sur vos propres serveurs AWS, Azure ou locaux pour assurer la pleine propriété du système.
Quelle est la différence entre l'API Standard et le pipeline Premium ?
Le package Standard vous donne le réseau neuronal entraîné encapsulé dans un endpoint FastAPI pour que votre application puisse lui envoyer des données et recevoir une prévision. Le package Premium est un écosystème complet : il inclut l'API, une base de données de séries temporelles (InfluxDB/TimeScale) pour stocker les données entrantes, et un tableau de bord Grafana en direct.