Parcourir les catégories
Explorer
Fiverr Pro
Français
$
USD
Traduction automatique
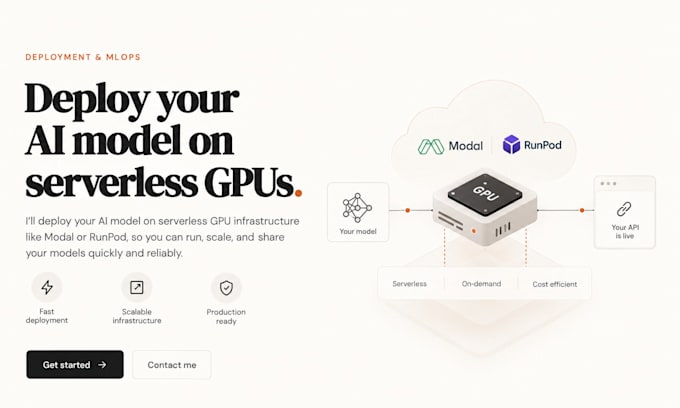
Je conçois et optimise des backends d'inférence AI pour des applications nécessitant une véritable puissance de calcul GPU, pas seulement une interface autour de l'API ChatGPT.
J'ai déployé et optimisé des pipelines AI en production (traitement d'images/vidéos, modèles génératifs de style face-swap) sur l'infrastructure GPU sans serveur de Modal, notamment :
- Configuration des instances GPU/CPU (L4/T4) ajustée pour l'équilibre entre coût et latence
- Optimisation du cold-start et du warmup pour réduire le temps de GPU gaspillé
- Capture d'instantanés de la mémoire GPU pour diminuer le temps de cold-start
- Optimisation des pipelines : réduction d'environ 75 % du temps de traitement sur une charge de travail en production
- Gestion des signaux et corrections de fiabilité pour les tâches d'inférence longues
Mobile App Developer
Langues
Traduction automatique
