Parcourir les catégories
Explorer
Fiverr Pro
Français
$
USD
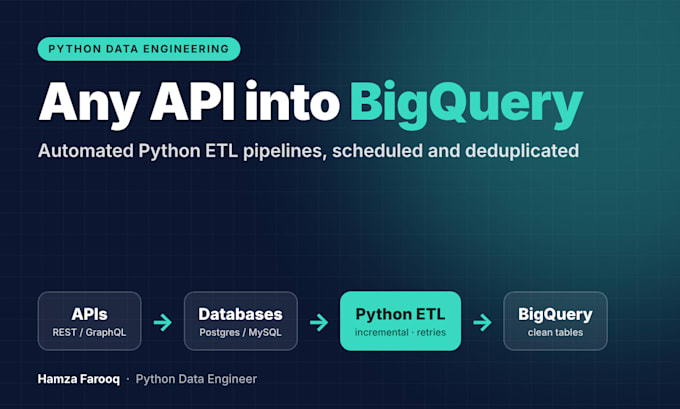
Ingénieur data Python pour les pipelines ETL BigQuery et les intégrations API
Vos données restent-elles bloquées dans des API, des bases de données et des feuilles de calcul exportées manuellement chaque semaine ? Je les remplace par un pipeline Python automatisé qui les charge de manière fiable dans BigQuery.
Je suis ingénieur de données Python avec plus de 3 ans d’expérience. Dans mon rôle actuel, je conçois et exploite des pipelines de production qui extraient les données de plusieurs API de plateformes vers un entrepôt BigQuery.
Ce que je mets en place
Fonctionnement
Non inclus: licences de connecteurs payantes, accès API dont vous ne disposez pas, ou surveillance continue (voir les options).
Écrivez-moi avec vos sources et destinations et je vous recommanderai le bon package.
Destination Platform:
Google BigQuery
•
PostgreSQL
•
mySQL
Outils et plateformes:
Autres
Traduction automatique
De quoi avez-vous besoin de ma part pour commencer ?
La documentation API ou des fichiers échantillons, les champs dont vous avez besoin et votre projet BigQuery. Veuillez accorder l'accès via un compte de service ou OAuth dans votre propre compte avec les autorisations minimales nécessaires. Ne m'envoyez jamais le mot de passe de votre compte principal.
Pouvez-vous travailler avec des bases de données autres que BigQuery ?
Oui. Je charge également des données dans PostgreSQL et MySQL, et j'ai automatisé les migrations Oracle PL/SQL vers PostgreSQL avec Python.
Le pipeline continuera-t-il de fonctionner après la livraison ?
Les pipelines Standard et Premium sont planifiés, réexécutables en toute sécurité et journaux pour chaque exécution ; le Premium envoie aussi des alertes en cas d'échec. Si l'API source change ultérieurement, des mises à jour sont disponibles via le support additionnel de 30 jours ou une offre personnalisée.
Quelles sources de données pouvez-vous connecter ?
Toute API REST ou GraphQL avec documentation et identifiants, PostgreSQL, MySQL, CSV/Excel, Google Sheets et Cloud Storage. Si votre source n'a pas d'API officielle, envoyez-moi un message d'abord et je vous confirmerai si c'est faisable.
Ai-je besoin de mon propre compte Google Cloud ?
Oui. Le pipeline s'exécute dans votre projet GCP, vous détenez donc le code, les données et la facturation. Je vous guiderai pour toute configuration nécessaire.
Combien cela va-t-il me coûter avec BigQuery ?
Cela dépend du volume de données, du stockage, des requêtes et de la fréquence de rafraîchissement. Je partitionne et regroupe les tables et conçois des requêtes afin de maîtriser les coûts. La facturation reste sur votre propre compte Google Cloud.
À quelle fréquence les données peuvent-elles être actualisées ?
Horaire horaire, quotidien ou selon un planning personnalisé, limité par les limites de débit de votre API source. Le streaming en temps réel fait l'objet d'un devis personnalisé.
Combien de données historiques pouvez-vous charger ?
Autant que le permet l'API source. Le premium inclut un backfill sur 12 mois, et l'add-on Historical backfill ajoute jusqu'à 24 mois supplémentaires.