Parcourir les catégories
Explorer
Fiverr Pro
Français
$
USD
Ingénieur AWS Amazon Connect Terraform et DevOps
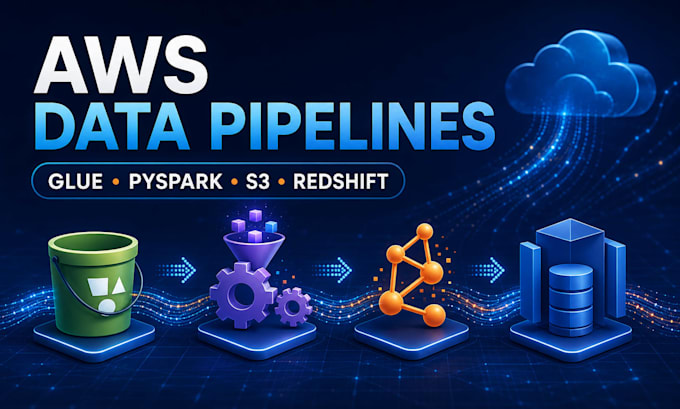
Vous avez besoin d’un pipeline de données AWS fiable, à construire, réparer ou optimiser ?
Je suis un ingénieur Cloud et DevOps certifié AWS, avec une expérience pratique dans la conception de pipelines de données d’entreprise utilisant AWS Glue, PySpark, Amazon S3, Amazon Redshift, Python, Terraform et GitHub Actions.
Je peux vous aider avec :
Développement et dépannage de jobs AWS Glue ETL
Ingestion S3, partitionnement et traitement Parquet
Transformations PySpark et gestion du schéma
Staging Redshift, chargement, MERGE et déduplication
Conversion de timestamps, rechargements et chargements incrémentiels
Vérifications de la qualité des données, validation et surveillance
Configuration du Glue Catalog et du crawler
Workflows d’infrastructure Terraform et déploiement CI/CD
Optimisation des performances et des coûts des pipelines
Analyse des causes profondes des erreurs liées au schéma ou à l’environnement
Mon expérience inclut la création de pipelines en production pour des données JSON complexes, la mise à plat de structures imbriquées, l’application de la logique de dernier enregistrement, la résolution de conflits de types, et la promotion de changements contrôlés à travers les environnements de développement, de test et de production.
Veuillez me contacter avant de commander si votre pipeline comporte plusieurs sources, de grands rechargements, des schémas complexes ou des exigences de déploiement en production.
Destination Platform:
Amazon Redshift
•
Amazon S3
Outils et plateformes:
Autres
Traduction automatique
Pouvez-vous réparer un job AWS Glue existant ?
Oui. Partagez le script, les détails des erreurs, le résultat attendu, un exemple de schéma et les logs pertinents. Supprimez les données confidentielles et les identifiants avant d’envoyer quoi que ce soit.
Pouvez-vous charger des données dans Amazon Redshift ou Amazon S3 ?
Oui. Je peux créer ou améliorer des flux ETL qui ingèrent, transforment, valident et chargent des données dans Amazon S3 ou Amazon Redshift.
Pouvez-vous gérer des JSON imbriqués, des changements de schéma et des rechargements ?
Oui. Je peux aplatir des JSON imbriqués, gérer les conflits de schéma et de type, appliquer la déduplication et concevoir des rechargements historiques contrôlés.
Pouvez-vous déployer le pipeline avec Terraform et CI/CD ?
Oui. La portée Standard ou Premium peut inclure Terraform et des workflows de promotion automatisés utilisant GitHub Actions, selon votre environnement.
