Parcourir les catégories
Français
$
USD
Connectez votre assistant IA à Fiverr
Traduction automatique
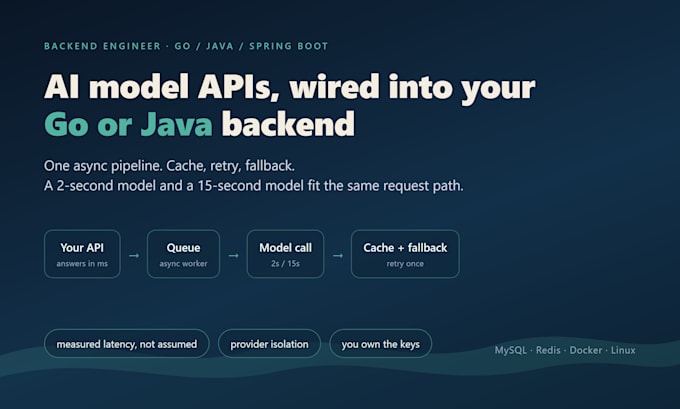
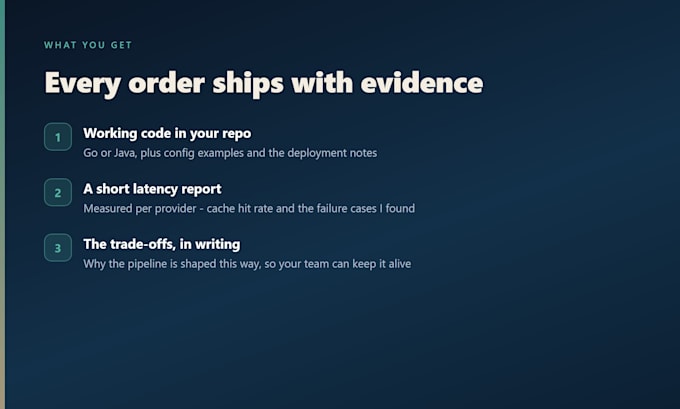
Vous souhaitez une fonctionnalité d'IA dans votre backend qui survive aux vrais utilisateurs — pas un notebook de démonstration. Je suis ingénieur backend (Go / Java / Spring Boot). J'ai construit la version de production : trois modèles derrière UNE seule pipeline asynchrone, un cache devant eux, et une interface fournisseur suffisamment légère pour que changer de fournisseur ne nécessite qu'une configuration. Ce que je fais : - API de modèles derrière une seule pipeline asynchrone : un modèle à 2s et un à 15s qui suivent le même chemin, et la page n'attend jamais - Cache + réessai + fallback : réessayer une fois, puis passer au fournisseur suivant - Isolation du fournisseur : une interface, un adaptateur par fournisseur, pas de SDK fournisseur dans votre code - Budget de latence explicite : mesuré, pas supposé Ce que vous obtenez : - Code fonctionnel dans votre repo (Go ou Java), avec exemples de configuration - Un court rapport : latence mesurée par fournisseur, taux de hit du cache, cas d'échec - Notes de déploiement et compromis, par écrit Ce dont j'ai besoin : - Où le code réside et comment il se déploie - Quels fournisseurs vous utilisez, et les clés API (les vôtres — vous gérez les coûts) - Un bon résultat et un mauvais résultat ; cela vaut mieux qu’un cahier des charges Pas adapté si vous avez besoin d’un modèle entraîné de zéro, RAG sur un grand corpus, ou une intégration uniquement frontend. Contactez-moi d’abord.
Backend Engineer
Langues
Traduction automatique
Traduction automatique
Utilisez-vous RAG ou des bases de données vectorielles ?
Pas dans cette service. J'intègre les API de modèles de manière défensive : une seule pipeline asynchrone, une interface fournisseur, plus cache, réessai et fallback. Si vous avez besoin de récupération sur un grand corpus avec un ensemble d’évaluation, c’est un autre scope et je le dirai honnêtement.
Qui fournit les clés API de l'IA ?
Vous le faites — vous possédez le compte et les coûts. Je réalise l’intégration et je garde les clés dans la configuration ou un gestionnaire de secrets, jamais codées en dur dans le repo.
Dans quels langages et frameworks travaillez-vous ?
Go et Java (Spring Boot) pour le backend, plus MySQL, Redis, Docker et Linux en production. Le travail frontend n’est pas ce pour quoi cette service est conçue.
Pouvez-vous garantir la qualité des résultats du modèle ?
Non, et je ne vais pas faire semblant. Je rends le pipeline fiable et mesurable : délais d’attente, réessais, fallback, appels en cache et un vrai chiffre de latence par fournisseur. La qualité des résultats dépend d’un prompt et du fournisseur que nous ajustons ensemble.