Parcourir les catégories
Explorer
Fiverr Pro
Français
$
USD


Traduction automatique
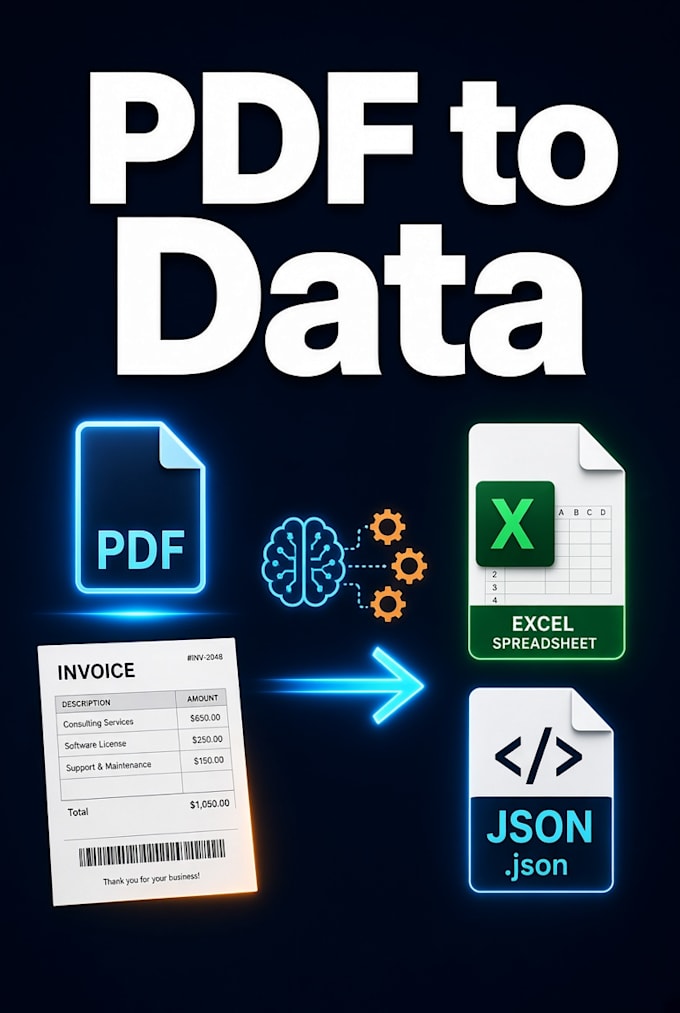
Transformez des documents non structurés en données structurées et exploitables grâce à l'IA.
Passez-vous des heures à extraire manuellement des informations de PDFs, factures, formulaires, contrats ou documents scannés ?
Je vais créer une pipeline de traitement de documents sur mesure utilisant Python, OCR et extraction de données alimentée par l'IA pour automatiser votre flux de travail.
Ce que je peux réaliser pour vous :
Ma démarche
AI Architect, Automation Specialist for Intelligent Sales Pipelines
Langues
Traduction automatique
Traduction automatique
Quels types de documents pouvez-vous traiter ?
Je peux travailler avec des PDFs, des documents scannés, des factures, des reçus, des formulaires et d'autres documents professionnels. Merci de partager un exemple afin que je puisse évaluer la mise en page et la complexité.
Pouvez-vous extraire des données de PDFs scannés ?
Oui. Je peux utiliser l'OCR pour extraire le texte des PDFs scannés et des images. La précision dépend de la résolution, de la lisibilité, de la mise en page du document et de la langue.
Pouvez-vous retourner les données extraites sous forme de JSON ou Excel ?
Oui. Selon le package, je peux fournir un JSON structuré, un CSV ou un fichier Excel.