Parcourir les catégories
Explorer
Fiverr Pro
Français
$
USD
Sachez ce qu'il faut créer avant d'investir dans l'IA, les données, les logiciels et les systèmes cloud
Niveau 1
Répond à certains critères de performance et présente un fort potentiel sur la place de marché.
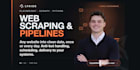
LYKIOS propose du web scraping en Python et de l'extraction de données pour les entreprises qui ont besoin de données propres et exploitables provenant de sites web. Nous réalisons des extractions ponctuelles, des scrapers réutilisables et des pipelines de données programmés.
Ce que nous pouvons collecter :
Nous utilisons des outils tels que Playwright, Scrapy, Beautiful Soup et Pandas pour extraire les champs que vous spécifiez, puis nettoyer et dédupliquer les résultats.
Choisissez Basic pour une extraction ponctuelle en CSV ou Excel jusqu'à 50 pages sur un seul site. La formule Standard inclut un scraper Python réutilisable pour jusqu'à 500 pages sur un seul site. La formule Premium comprend un pipeline programmé pour jusqu'à 2000 pages réparties sur trois sites, avec des journaux et 30 jours de support.
Besoin d'une livraison vers une feuille, une base de données ou une API ? Contactez-moi pour un devis personnalisé. Envoyez les URLs des sites, les champs dont vous avez besoin, et indiquez si le travail est ponctuel ou récurrent. Je vérifierai la faisabilité et vous recommanderai la formule adaptée.
Technologie:
Python
•
scrapy
•
Beautiful Soup
•
Playwright
•
Pandas
Technique:
Automatisé(e)
Traduction automatique
Pouvez-vous gratter n'importe quel site Web?
Envoyez-moi l'URL avant de commander. Je vérifierai la structure du site, son accessibilité et les champs dont vous avez besoin, puis je confirmerai ce qui peut être livré. Certains sites ou pages peuvent ne pas être adaptés au scraping.
Quelle est la différence entre les forfaits ?
Basic fournit un fichier CSV ou Excel ponctuel. Standard ajoute un scraper Python réutilisable pour un site. Premium inclut un pipeline programmé pour jusqu'à trois sites, avec journaux et 30 jours de support. Les limites de pages sont indiquées dans chaque formule.
Qu'est-ce qu'une page ou une source ?
Une page correspond à une URL traitée. Une source désigne un site ou un domaine. Merci de m’envoyer des exemples d’URLs avant de commander pour que je puisse confirmer comment votre projet s’inscrit dans les limites de la formule.
Quel format vais-je recevoir ?
Basic inclut CSV ou Excel. Si vous souhaitez une livraison via Google Sheets, une base de données ou une API, contactez-moi avant de commander pour un devis personnalisé.
Le scraper peut-il fonctionner automatiquement ?
Premium comprend un pipeline programmé. Indiquez-moi la fréquence des mises à jour et le lieu d'exécution pour que je puisse confirmer la configuration et les éventuels coûts d’hébergement.
Que faire si le site change plus tard ?
Le support Premium couvre 30 jours pour les sources et champs convenus. La maintenance continue après cette période peut faire l’objet d’un devis séparé.