Parcourir les catégories
Explorer
Fiverr Pro
Français
$
USD
Développeur d’automations Python et IA locale
Je vais extraire des données structurées de documents PDF en texte natif et les livrer dans un format propre et réutilisable.
Je peux extraire des champs spécifiques à partir de factures, rapports, formulaires, relevés et autres PDFs structurés ou semi-structurés en Excel, CSV ou JSON selon le forfait choisi.
Mon processus peut inclure :
Extraction de données par champ
Sortie en Excel et CSV
Sortie en JSON sur Standard et Premium
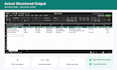
Références de page pour les valeurs extraites
Avertissements pour valeurs manquantes ou invalides
Validation des données
Rapport de contrôle qualité et livraison en ZIP organisé
Règles de validation personnalisées sur Premium
Je ne devine pas les valeurs manquantes. Si une valeur ne peut pas être trouvée de manière fiable, elle sera laissée vide ou signalée pour révision.
Ce service est conçu pour les PDFs en texte natif. La reconnaissance optique de caractères (OCR), les documents manuscrits, les fichiers protégés par mot de passe, les connexions à des comptes, l’intégration API et l’accès aux systèmes de production ne sont pas inclus.
Veuillez envoyer les PDFs, les champs exacts que vous souhaitez extraire, et votre format de sortie préféré.
Toute communication et livraison peuvent être gérées de manière asynchrone via Fiverr.


Technologie:
Excel
•
Python
Traduction automatique
Quels types de fichiers PDF supportez-vous ?
Je supporte les documents PDF en texte natif où le texte peut être sélectionné ou copié. Les PDFs scannés en image et les documents manuscrits nécessitant OCR ne sont pas inclus.
Quels formats de sortie fournissez-vous ?
Excel et CSV sont disponibles dans tous les forfaits. La sortie JSON est incluse dans Standard et Premium.
Pouvez-vous extraire des champs spécifiques que je choisis ?
Oui. Veuillez fournir les noms exacts des champs que vous souhaitez extraire, comme numéro de facture, date, nom de la société, montant total, email ou autres champs spécifiques au document.
Fournissez-vous des références de page ?
Oui. Les valeurs extraites peuvent inclure la source PDF et la référence de page afin que vous puissiez retracer l’origine de chaque valeur.
Que se passe-t-il si une valeur ne peut pas être trouvée ?
Je n’invente pas ni ne devine les valeurs manquantes. Le champ sera laissé vide ou signalé pour révision selon le résultat de l’extraction et de la validation.
Pouvez-vous valider les données extraites ?
Oui. Standard et Premium incluent des avertissements de validation. Premium peut également inclure des règles de validation personnalisées selon vos besoins.
Supportez-vous les PDFs scannés ou l'OCR ?
Non. Ce service est actuellement limité aux PDFs en texte natif. Les scans uniquement images et les documents manuscrits nécessitant OCR ne sont pas pris en charge.
Pouvez-vous accéder à mon compte, site web, API ou base de données ?
Non. Ce service est uniquement basé sur des fichiers. Je n’ai pas besoin d’accès à des comptes, API, bases de données ou systèmes de production.
Avons-nous besoin d’un appel vidéo ou d’une réunion ?
Non. Le projet entier peut être géré de manière asynchrone via les messages et échanges de fichiers sur Fiverr.
Que dois-je envoyer avant le début de la commande ?
Veuillez envoyer les PDFs sources, les champs exacts à extraire, votre format de sortie préféré, ainsi que toutes règles de validation ou exemples de sortie que vous souhaitez que je suive.


