Parcourir les catégories
Explorer
Fiverr Pro
Français
$
USD

Traduction automatique
Vous recherchez un chatbot IA de niveau entreprise pour interroger vos PDFs, documents ou base de connaissances avec une grande précision ? Je crée des applications Retrieval-Augmented Generation (RAG) personnalisées, de bout en bout, en utilisant Python et des outils d’IA modernes.
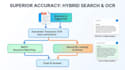
CE QUE VOUS OBTENEZ : Recherche hybride avancée : Combine la correspondance de mots-clés BM25 avec le re-ranking neuronal (Cohere) pour une précision maximale de la récupération.
Support PDF scanné : Passage automatique à Tesseract OCR pour les documents riches en images ou numérisés.
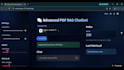
Interface utilisateur personnalisée : Tableau de bord moderne et réactif avec Streamlit, thèmes sombres/navy personnalisables et contrôles des hyperparamètres.
Citations de sources en ligne : Génération de réponses précises avec attribution directe au nom de fichier et à la page.
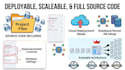
Code source propre : Code Python entièrement documenté, modulaire, prêt pour le déploiement en cloud.
PILIER TECHNIQUE : Python | Streamlit | PyMuPDF | Tesseract OCR | OpenAI API | Cohere | Bases de données vectorielles
Envoyez-moi un message ou passez votre commande dès aujourd'hui pour transformer vos documents complexes en un assistant IA interactif !
Une démo en direct est disponible !
Contactez-moi pour tester l’application RAG interactive Streamlit en temps réel
Python Developer for RAG Chatbots, LangChain, and AI Agents
Langues
Traduction automatique
Traduction automatique
Ai-je besoin de mes propres clés API ?
Oui, vous aurez besoin de vos propres clés API Groq et Cohere, qui sont gratuites à obtenir. Je vous guiderai pour les configurer.
Ce processus peut-il traiter des PDFs d'images scannées ?
Oui, l'application inclut une fonction de fallback automatique Tesseract OCR pour extraire et indexer le texte des documents scannés.


