Parcourir les catégories
Français
$
USD
Connectez votre assistant IA à Fiverr
Ingénieur de données
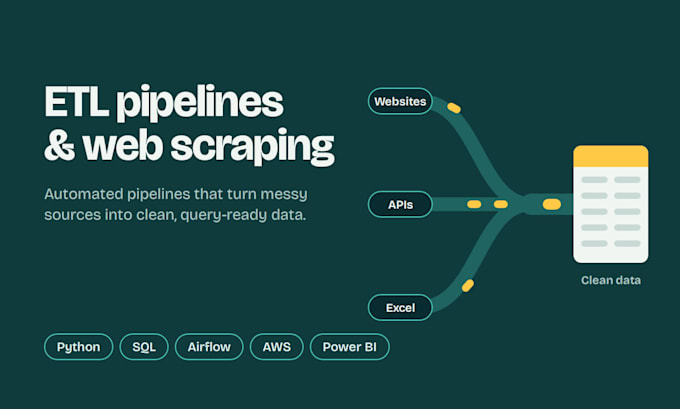
Vous avez besoin de données provenant de sites Web, ou vous disposez de données mais sans système fiable pour les exploiter ? Feuilles de calcul, API et bases de données qui ne s’alignent jamais, rapports reconstruits manuellement chaque semaine, pipelines qui se cassent du jour au lendemain ? Je règle tout cela.
Je suis ingénieur data avec 4 ans d’expérience et une maîtrise en Big Data Analytics du Royaume-Uni. Je conçois actuellement des pipelines de production pour de grandes places de marché en ligne, y compris des tables de faits Redshift incrémentales de plus de 20 millions d’enregistrements.
Ce que je construis :
Pourquoi moi : une réelle expérience en production, du code propre et documenté que vous possédez, et des mises à jour claires à chaque étape.
Veuillez me contacter avant de commander afin que je puisse bien cadrer votre projet.
Traduction automatique
Avec quels outils travaillez-vous ?
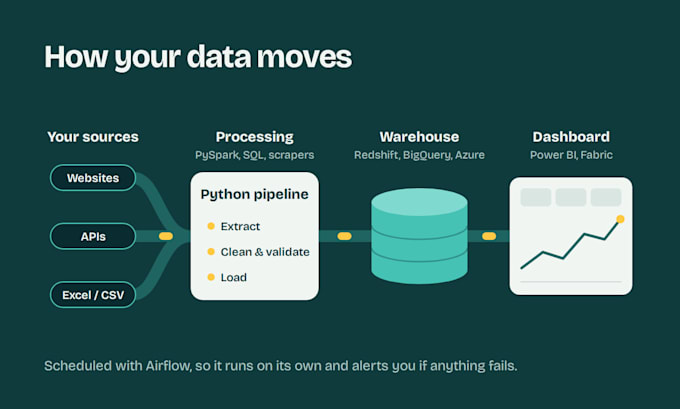
Python, SQL, PySpark, Apache Airflow, Matillion, Talend, AWS (Redshift, Lambda), Azure, Google BigQuery et Power BI, ainsi que BeautifulSoup, Requests, Selenium, Scrapy et Playwright pour le web scraping.
Pouvez-vous scraper des sites qui chargent du contenu via JavaScript ?
Oui. Pour les sites dynamiques, j’utilise des outils d’automatisation de navigateur comme Selenium ou Playwright plutôt que de simples requêtes de pages.
Pouvez-vous travailler avec mon pipeline existant ?
Oui. Je peux déboguer, optimiser ou étendre les pipelines que vous possédez déjà, y compris corriger les doublons ou les enregistrements manquants.
Dans quel format vais-je recevoir mes données ?
CSV, Excel, JSON, Google Sheets, ou chargés directement dans votre base de données ou votre data warehouse.
Suis-je propriétaire du code ?
Oui. Vous obtenez l’intégralité du code source, et les versions Standard et Premium incluent également la documentation.
Réalisez-vous du web scraping sur n'importe quel site ?
Je ne scrape que des données publiquement disponibles. Je n’explore pas les réseaux sociaux ni quoi que ce soit derrière un login sans autorisation, car cela va à l’encontre des règles de Fiverr.
Pouvez-vous construire des pipelines en temps réel ?
Les pipelines par lots planifiés constituent mon offre principale. Pour les besoins en temps réel, envoyez-moi un message d’abord et nous vérifierons si cela convient.