Parcourir les catégories
Explorer
Fiverr Pro
Français
$
USD
Spécialiste du Web Scraping, de l’automatisation AI et du backend FastAPI
Vous avez du mal à collecter manuellement des données de sites web ? Je le ferai pour vous rapidement, proprement et de manière fiable.
Je suis développeur Python spécialisé en web scraping et extraction de données. Je crée des scrapers personnalisés pour collecter des données structurées à partir de sites web et les livrer dans un format propre, prêt à l’emploi.
CE QUE JE PEUX EXTRAIRE
Listes de produits
Répertoires d’entreprises
Informations de contact et d’entreprise
Annonces immobilières
Données e-commerce
Données de sites publics
Autres données web structurées
CE QUE VOUS RECEVEZ
Web scraping en Python
BeautifulSoup, Requests, Selenium et Playwright
Gestion de pages multiples et pagination
Scraping de sites statiques et dynamiques
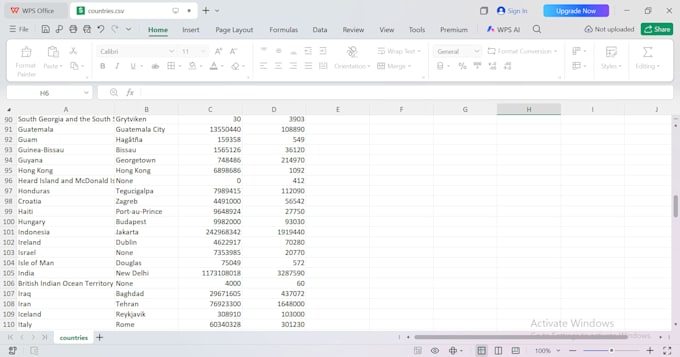
Données propres en CSV, Excel ou JSON
Nettoyage et mise en forme des données
Gestion des erreurs pour un scraping fiable
POURQUOI TRAVAILLER AVEC MOI
Je ne me contente pas de collecter des données, je m’assure qu’elles sont propres, organisées et prêtes à l’emploi.
Dans un projet récent, j’ai extrait plus de 1 000 enregistrements sur plus de 50 pages sans aucune erreur, y compris la pagination automatique et une sortie CSV structurée.
Vous avez un projet ou une exigence spécifique en matière de données ? Contactez-moi avant de commander. Je vais examiner vos besoins et confirmer la portée avant que vous passiez commande.
Transformons ensemble des données web désorganisées en quelque chose d’utile pour votre entreprise.
Technologie:
Python
•
sélénium
•
Beautiful Soup
•
Playwright
•
Pandas
Technique:
Autres
Traduction automatique
Quels sites Web pouvez-vous gratter ?
La plupart des sites publics — e-commerce, répertoires, listes, et plus encore. Envoyez-moi votre site cible et je confirmerai la faisabilité avant votre commande.
Dans quel format vais-je recevoir les données ?
CSV ou Excel par défaut. JSON disponible sur demande.
Gérez-vous les sites nécessitant une connexion ou ayant des protections anti-bot ?
Le scraping basique basé sur la connexion est possible — envoyez-moi d’abord les détails pour que je puisse confirmer la portée et le prix.