Parcourir les catégories
Explorer
Fiverr Pro
Français
$
USD
Traduction automatique
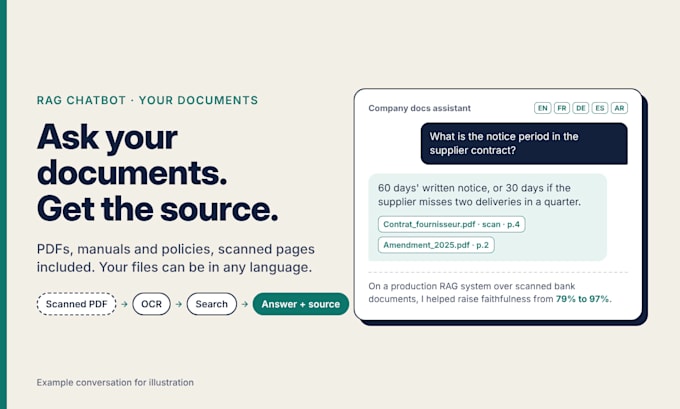
Votre équipe pose les mêmes questions et les réponses sont enfouies dans des PDFs, des politiques et des manuels. Un chatbot n'est utile que s'il répond à partir de ces fichiers et indique d'où proviennent chaque réponse.
Je conçois des chatbots RAG qui font cela, en anglais, en arabe ou les deux. Les PDFs numérisés conviennent. L'OCR est l'une des causes d'échec silencieux de nombreux projets, je le traite donc comme un travail réel.
Pour mettre les choses en contexte : chez GBG, j'ai travaillé sur la majeure partie du pipeline pour un chatbot RAG en arabe basé sur les documents internes d'une banque. Une meilleure OCR et une meilleure récupération ont permis de faire monter la fiabilité des réponses de 79% à 97% sur notre jeu de tests.
Ce que vous obtenez :
- Vos documents traités (PDF, Word, texte, scans)
- Recherche hybride (par mot-clé + sémantique) avec réévaluation
- Réponses avec citations sources
- Un backend FastAPI que vous possédez, plus une page de chat simple
- Un court rapport de test : ce qui est correct et les points à améliorer
Pile technologique : Python, LangChain/LangGraph, OpenAI ou Azure OpenAI (ou le modèle que vous préférez), Qdrant ou Azure AI Search, Docker.
Envoyez-moi un message avec les documents dont vous disposez et qui utilisera le bot. Si RAG n'est pas adapté, je vous le dirai.
AI Engineer building RAG systems, LLM agents and Arabic NLP
Langues
Traduction automatique
Traduction automatique
Cela peut-il répondre dans plusieurs langues et lire des PDFs numérisés ?
Oui ! Je peux construire votre chatbot RAG dans la langue de votre choix. Les PDFs numérisés peuvent être traités via OCR pour extraire le texte. La précision dépend de la langue, de la qualité du scan et de la mise en page, je testerai donc d’abord un échantillon.
Le chatbot invente-t-il des choses ?
Tout LLM peut le faire. Je l'améliore avec une bonne récupération, des citations et en indiquant au bot de dire qu’il ne sait pas lorsque vos documents ne couvrent pas la question. Les versions Business et Production incluent un rapport de test pour que vous voyiez où cela échoue encore.
Quel modèle d’IA utilisez-vous, et qui paie les coûts de l’API ?
OpenAI ou Azure OpenAI par défaut, mais je peux utiliser un autre fournisseur ou un modèle open-source. L’utilisation est facturée sur votre propre compte, vous contrôlez donc le coût. Je vous donnerai une estimation approximative du coût par question.
Suis-je propriétaire du code ?
Oui. Vous obtenez le code source complet et les instructions de configuration. Rien n’est lié à mes comptes.
Pouvez-vous l’ajouter à mon site web ?
Oui, en option. Je peux vous fournir un widget de chat intégrable, ou votre développeur peut appeler l’API depuis votre site existant.
Mes données sont-elles en sécurité avec vous ?
J’utilise vos documents uniquement pour votre projet et je supprime mes copies après livraison. Pour les données sensibles, tout peut fonctionner sur votre propre compte Azure ou AWS.
