Parcourir les catégories
Explorer
Fiverr Pro
Français
$
USD
Traduction automatique
Votre chatbot RAG semblait parfait lors de la démonstration. Puis des utilisateurs réels ont posé des questions réelles, et il donne maintenant des réponses erronées avec une confiance totale.
Généralement, le problème ne vient pas du modèle lui-même. Cela vient de la récupération, du découpage ou d’un texte issu de l’OCR cassé. Je détermine lequel, avec des chiffres plutôt que des suppositions.
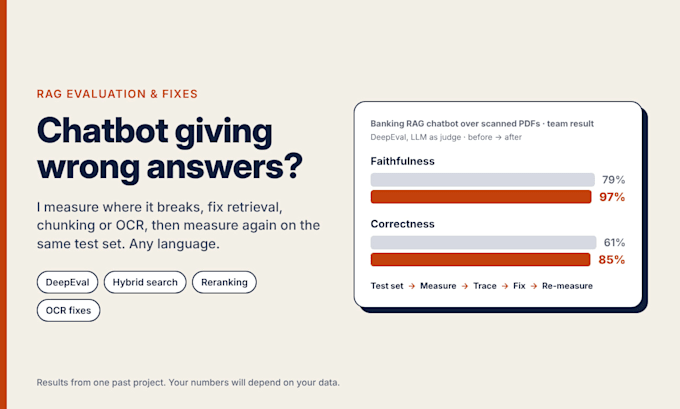
C’est le travail que je maîtrise le mieux. Sur un chatbot bancaire analysant des PDFs scannés chez GBG, nous avons mesuré la fidélité à 79 %. Après avoir corrigé l’OCR et ajouté une recherche hybride, un ré-ranking et une réécriture des requêtes, le score est passé à 97 %, et la justesse est passée de 61 % à 85 % (DeepEval, LLM comme juge).
Comment cela fonctionne :
1. Je construis un ensemble de tests à partir de vos documents et des questions réelles des utilisateurs
2. Je mesure la fidélité, la justesse et la qualité de récupération
3. Je relie chaque échec à sa cause : analyse, découpage, recherche, classement ou prompt
4. Vous obtenez un plan de corrections, ou je réalise les corrections et je le réévalue
Vous obtenez un court rapport avec les chiffres avant/après sur le même jeu de tests. Je ne promets pas un chiffre précis, car cela dépend de vos données.
Fonctionne avec LangChain, LlamaIndex ou des pipelines Python simples, dans n’importe quelle langue dans laquelle vos documents sont écrits.
Envoyez-moi quelques exemples de mauvaises réponses. Cela suffit souvent pour que je vous indique où je regarderais en premier.
AI Engineer building RAG systems, LLM agents and Arabic NLP
Langues
Traduction automatique
Traduction automatique
Avez-vous besoin d'accéder à mon code ?
Pour l’audit, une API fonctionnelle ou un accès lecture suffit. Pour effectuer les corrections, j’ai besoin du code, idéalement d’un dépôt privé Git auquel vous m’inviteriez. Je n’ai pas besoin de mots de passe de production.
Pouvez-vous promettre un chiffre précis de précision ?
Non, et je serais prudent avec quiconque affirme le contraire. Cela dépend de vos documents et de vos questions. Ce que je promets, ce sont des scores avant et après sur le même jeu de tests, afin que vous voyiez exactement ce qui s’est amélioré.
Quels outils utilisez-vous pour l’évaluation ?
Principalement DeepEval avec un juge LLM, plus des vérifications pour s’assurer que les bons morceaux ont été récupérés. Si vous utilisez déjà RAGAS ou votre propre configuration, je peux m’y adapter.
La langue de mes documents compte-t-elle ?
Le processus reste le même. La langue a surtout un impact sur l’OCR, la segmentation du texte et la qualité de la recherche, et je vérifie ces aspects spécifiquement. J’ai surtout travaillé avec l’arabe et l’anglais. Indiquez-moi la vôtre et je dirai honnêtement si cela convient.
Et si la vraie correction nécessite une architecture différente ?
Alors le rapport le dira, avec une estimation approximative, avant que je n’écrive le moindre code. Vous décidez de la suite.
