Responsabilités centrales
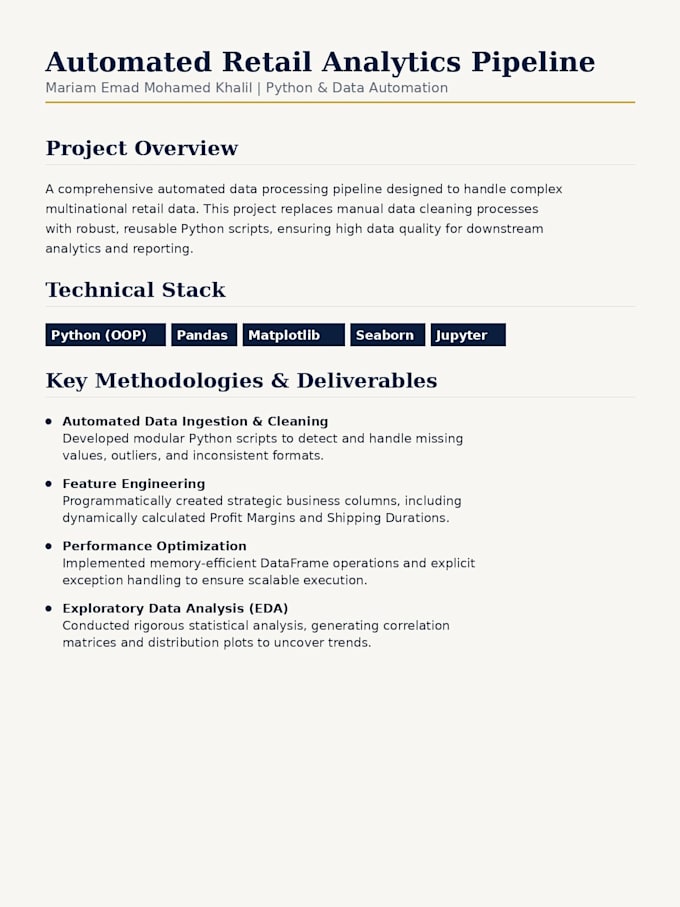
- Nettoyage et traitement des données : filtrer les erreurs, gérer les valeurs manquantes et restructurer les flux bruts à l’aide de bibliothèques Python comme Pandas afin d’assurer l’exactitude analytique.
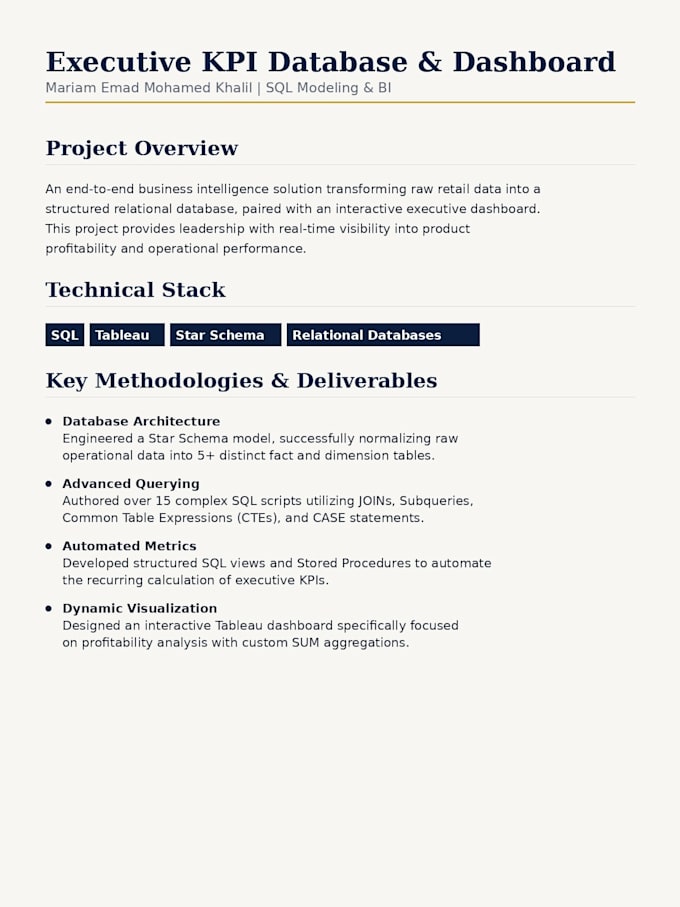
- Architecture de bases de données : écrire des requêtes SQL complexes avec des CTE et des procédures stockées, ou concevoir des schémas étoile normalisés pour organiser des sources de données disparates.
- Visualisation et BI : construire des tableaux de bord interactifs dans Tableau, en veillant à ce que les calculs côté serveur (par exemple l’agrégation avec SUM plutôt que des moyennes au niveau des lignes) maintiennent un filtrage dynamique correct.
Livrables typiques sur le marché
- Pipeline automatisés : scripts personnalisés qui extraient, traitent et nettoient régulièrement les données provenant de sources web ou d’API.
- Tableaux de bord de performance : rapports visuels mettant en évidence la performance des produits au détail, la rentabilité et les indicateurs de haut niveau à l’aide de Matplotlib, Seaborn