Parcourir les catégories
Explorer
Fiverr Pro
Français
$
USD

Traduction automatique
Ingénieur Backend IA | Pipelines RAG · Intégration LLM · Systèmes agentiques
Je suis un ingénieur logiciel senior avec plus de 12 ans d'expérience dans la création de systèmes IA en production. Je suis l'architecte unique de Teqit, une plateforme d'entreprise en direct avec des pipelines RAG, une inférence LLM sur site et des microservices agentiques servant plus de 10 clients.
Ce que je construis pour vous :
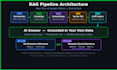
- Pipelines RAG ingestion de documents, recherche vectorielle, génération de réponses LLM
- Intégration API LLM OpenAI, Claude, Gemini ou tout modèle hébergé
- Inférence LLM locale avec Ollama / llama.cpp (réduction des coûts IA d'environ 70%)
- Outils de workflows agentiques appel de outils, raisonnement multi-étapes, pipelines de décision
- Backends FastAPI ou Scala via REST ou gRPC
- Routage hybride commutation intelligente entre modèles locaux et cloud
Pourquoi moi ?
J'ai réalisé cela en production réelle, pas en tutoriels. J'ai réduit les coûts IA de 70 % avec l'inférence locale, créé des pipelines vidéo génératifs pour avatars, et conçu des agents qui raisonnent de manière indépendante sur des bases de connaissances d'entreprise.
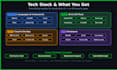
Tech : Python · FastAPI · Ollama · API OpenAI · Akka/Scala · Docker · AWS
Contactez-moi avant de commander, je vais d'abord examiner votre cas d'utilisation.
Senior AI and Backend Engineer
Langues
Traduction automatique
Traduction automatique
Pouvez-vous utiliser mes propres documents comme base de connaissances ?
Oui — PDFs, documents Word, fichiers texte ou bases de données. Je gère tout le pipeline d'ingestion et de découpage.
Puis-je héberger cela sur mon propre serveur ou AWS ?
Absolument. Je configure des déploiements Docker + AWS EC2 et peux les adapter à tout fournisseur cloud.
Ai-je besoin d’une clé API OpenAI ?
Seulement si vous souhaitez des modèles cloud. Pour l'inférence locale avec Ollama, aucune clé API externe n'est nécessaire.
Allez-vous partager le code source ?
Oui — le code source complet avec documentation est fourni pour tous les packages.
Pouvez-vous intégrer cela dans mon application existante ?
Oui, à condition que vous partagiez les spécifications API ou l'accès au code. Contactez-moi d'abord pour discuter de votre configuration.


