Parcourir les catégories
Français
$
USD
Connectez votre assistant IA à Fiverr
Ingénieur en automatisation IA : je crée des agents IA, des chatbots et des applications Vibe Coded
Votre modèle ML est précis, testé et bloqué dans un notebook Jupyter que personne ne va utiliser. Mettons cela au point.
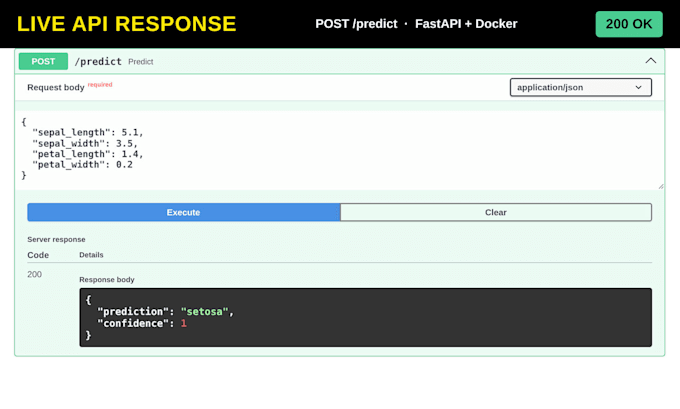
Je suis ingénieur en apprentissage automatique avec 3 ans d’expérience dans la mise en production d’IA. Je transformerai votre modèle entraîné en une API rapide et fiable que votre application, votre site ou votre équipe pourront utiliser immédiatement.
Ce que je déploie :
Ce que vous obtenez :
Pourquoi travailler avec moi :
Prêt à mettre votre modèle en production ? Envoyez-moi le type de modèle et l’hébergement souhaité, et je recommanderai le meilleur package. Ou commandez Basic et commençons.

Traduction automatique
Q : De quoi avez-vous besoin de moi pour commencer ?
A : Votre fichier de modèle entraîné (ou le code), une brève note sur ce qu’il prédit, et un exemple d’entrée et de sortie. Si vous avez une plateforme d’hébergement préférée, dites-le-moi.
Q : Quels modèles et cadres prenez-vous en charge ?
A : Modèles scikit-learn, PyTorch, TensorFlow et Hugging Face, ainsi que des applications LLM et RAG développées en Python.
Q : Entraînez-vous ou construisez le modèle pour moi ?
A : Non. Ce gig couvre uniquement le déploiement, vous apportez donc un modèle entraîné. Si vous avez besoin du développement du modèle, envoyez-moi un message avant de commander.
Q : Le Basic inclut-il l’hébergement cloud ?
A : Non. Basic vous fournit une API FastAPI Dockerisée qui fonctionne partout. Le déploiement en live sur AWS ou GCP s’effectue via Standard et Premium.
Q : Quelle est la différence entre Standard et Premium ?
A : Standard met votre API en ligne sur AWS ou GCP avec tests. Premium ajoute la surveillance, un pipeline CI/CD et une semaine de support après livraison.
Q : Vais-je recevoir le code source ?
A : Oui. Chaque package inclut le code source complet et une documentation simple, afin que vous puissiez le maintenir sans moi.
Q : Combien de temps prend la livraison ?
A : Basic prend 3 jours, Standard 5 jours et Premium 7 jours. Les modèles plus volumineux ou plus complexes peuvent nécessiter du temps supplémentaire, et je vous en informerai avant la commande.