Parcourir les catégories
Français
$
USD
Connectez votre assistant IA à Fiverr
Ingénieur Vision par ordinateur et AR, chercheur PhD
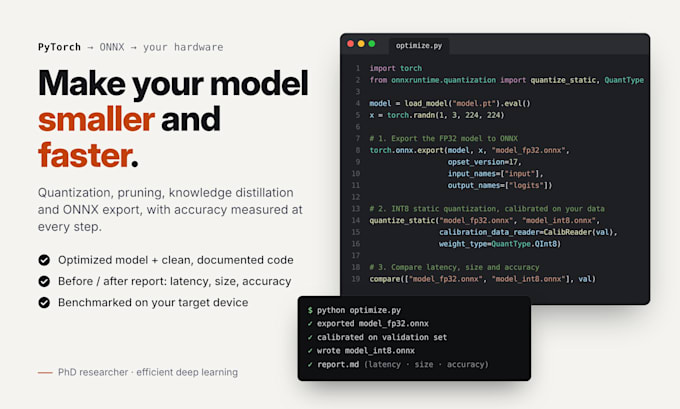
Votre modèle PyTorch est-il trop lent, trop volumineux ou trop coûteux à exécuter en production? Je suis chercheur en informatique et doctorant en vision par ordinateur, avec des publications évaluées par les pairs sur la compression de modèles et la distillation de connaissances. Je rendrai votre modèle plus petit et plus rapide tout en maîtrisant la perte de précision.
Ce que je peux faire :
Ce que vous obtenez :
Veuillez me contacter avant commande avec l’architecture de votre modèle, la version du framework, le matériel cible (GPU, CPU, Jetson, mobile) et le budget de précision, afin que je puisse confirmer le bon package.
Langage de programmation:
Python
•
Colab
Outils:
Jupyter Notebook
•
opencv
•
PyTorch
Frameworks:
keras
•
PyTorch
Traduction automatique
L’optimisation va-t-elle diminuer la précision de mon modèle ?
Certaines techniques peuvent entraîner une légère perte de précision. Nous convenons d’un budget de précision avant de commencer, je mesure chaque étape et vous obtenez des chiffres avant/après, sans surprise.
Quels modèles et frameworks supportez-vous ?
Principalement des modèles de vision PyTorch : classification, détection, segmentation et tâches similaires. Les modèles TensorFlow/Keras peuvent souvent être traités via ONNX. Si votre modèle est inhabituel, envoyez-moi un message d’abord et je vous dirai honnêtement si je peux aider.
Avez-vous besoin de mes données d'entraînement ?
La quantification et l’export ONNX nécessitent uniquement un petit ensemble de calibration/validation. La distillation et le fine-tuning nécessitent l’accès aux données d’entraînement. Votre modèle, code et données restent confidentiels et ne sont jamais réutilisés.
Quel matériel testez-vous ?
Je réalise des benchmarks sur les GPU NVIDIA RTX (TensorRT, ONNX Runtime GPU), les processeurs x86, les Mac Apple Silicon et les téléphones Android. Pour Jetson ou d’autres cartes edge, je fournis le modèle exporté ainsi qu’un script de benchmark que vous pouvez exécuter, ou je teste avec l’accès que vous fournissez.
Qu'est-ce que je reçois exactement ?
Les fichiers de modèle optimisés (par exemple ONNX ou un moteur TensorRT), un code Python propre qui reproduit chaque étape, et un court rapport avec les latences avant/après, la taille du modèle et la précision.
