Parcourir les catégories
Explorer
Fiverr Pro
Français
$
USD
Ingénieur logiciel IA
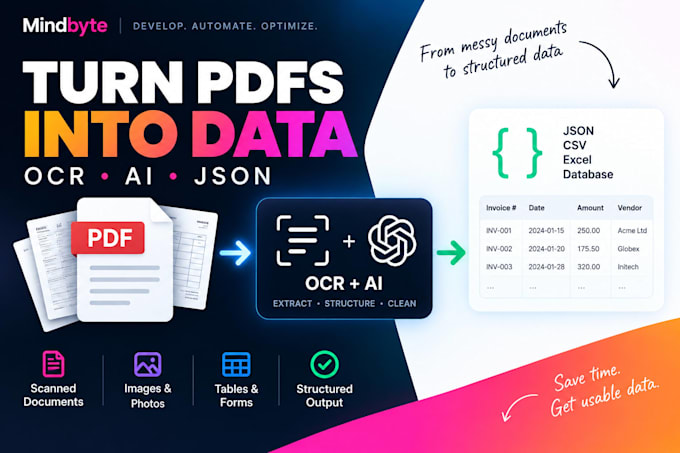
Je crée des pipelines OCR et de traitement de documents qui transforment les PDFs, scans et images en données structurées et exploitables.
Je peux extraire du texte, des tableaux, des dates, des références, des identifiants et des champs personnalisés, classer les documents, nettoyer les résultats et fournir une sortie structurée en JSON, CSV ou prête pour une base de données.
Selon le projet, je peux également développer des API, des traitements asynchrones, des recherches sémantiques ou des workflows RAG.
Mon objectif est de proposer un traitement de documents fiable et réutilisable plutôt qu'une simple conversion ponctuelle de PDF.
Veuillez envoyer des échantillons représentatifs de documents avant de commander des projets complexes.
Technologie:
Python
Traduction automatique
Pouvez-vous traiter des PDFs scannés ?
Oui. Je peux traiter des PDFs scannés et des images, y compris le prétraitement si nécessaire.
Pouvez-vous extraire des champs spécifiques ?
Oui. Les dates, identifiants, références, titres, types de documents et autres champs peuvent être extraits.
Pouvez-vous classer les documents ?
Oui. La classification peut utiliser des règles, l'apprentissage automatique ou l'IA selon le cas d'utilisation.
Pouvez-vous extraire des tableaux ?
Oui, en fonction de la mise en page du document et de la qualité du scan.
Pouvez-vous créer une API autour du pipeline ?
Oui. Une API REST et un traitement en arrière-plan peuvent être ajoutés.
Pouvez-vous traiter de grands volumes ?
Oui, mais les workflows à fort volume nécessitent généralement un périmètre personnalisé.
